在 Windows 本地部署 MiniMax H3:用 DeepSeek Harness 生成视频与音频
目录
答案是:当然可以。下面三段视频都是这次本地部署后生成的:一只骑车的鹈鹕、海边灯塔,以及雨天桥上的连续镜头。看完这几条样片,我觉得效果还不错;这只是个人主观观感,仅供参考,不代表每次生成都能稳定做到同样的镜头和细节。
整体部署思路
MiniMax H3 不是负责对话的文本大模型。在这套方案里,DeepSeek Harness 使用文本模型理解请求、决定何时调用工具;真正生成视频和音轨的是本机 ComfyUI 中加载的 H3。H3 的音视频在同一条生成过程中建模,输出 MP4 里包含视频和立体声音轨。MiniMax 的模型说明把 H3-Base 的视频与音频潜变量描述为联合预测。
1 | DeepSeek Harness / DeepSeek v4 |
MCP 服务器只负责把 Harness 的工具调用转换成 ComfyUI 工作流:提交 /prompt、轮询 /history,最后把生成文件路径交回 Harness。它本身不加载模型,也不占用主要显存。
这里的“本地部署”说的是视频推理和文件生成运行在本机。Harness 使用的文本模型是另一部分,整条链路不是离线运行(当然你如果本地再部署对应文本模型即可离线运行了,详见:>>)。
ComfyUI + MiniMax H3
实测机器是 Windows 11、Ryzen 9 9950X3D、64 GB 内存和 RTX 5080 16 GB。已有 ComfyUI 版本是 0.37.0(之前本地部署生图模型时有介绍过,详见:>>),H3 所需节点和工作流模板已经包含在内,所以我复用了上一期的源码和 Python 虚拟环境,没有另装一份 ComfyUI。ComfyUI 的 H3 文档也说明,H3 工作流由原生节点支持;模型文件则可以放在单独目录,再通过模型路径配置接入。ComfyUI MiniMax H3 文档
本次使用的是 H3-Base 的 FL2VA 路线。核心文件分布在扩散模型、文本编码器和视频、音频 VAE 中;Turbo LoRA 和风格 embedding 用于可选的快速预览与风格控制。
| 文件 | 用途 | 约占空间 |
|---|---|---|
minimax_h3_fl2va_pruned_int8_convrot.safetensors |
视频扩散模型 | 19.53 GiB |
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
文本编码器 | 14.61 GiB |
minimax_h3_video_vae_int8_convrot.safetensors |
视频 VAE | 2.62 GiB |
minimax_h3_audio_vae_fp32.safetensors |
音频 VAE | 0.56 GiB |
| Turbo LoRA 与 10 个 embedding | 可选加速和风格文件 | 约 1.83 GiB |
基础模型文件合计约 37.3 GiB,带上 LoRA 和 embedding 后约 39.15 GiB。它显然装不进 16 GB 显存,但 ComfyUI 可以把模型分阶段载入显存,需要时再从系统内存换入。这里的 16 GB 是本机跑通的配置,不是对其他机器的最低要求。
实际下载时我把文件名作为位置参数传给 hf download,PowerShell 里不把一长串 --include 和续行混在一起:
1 | $env:HF_HUB_DISABLE_XET = "1" |
10 个 embedding 是可选项,可以单独用 --include 'embeddings/*' 下载。PowerShell 的命令续行符是反引号;当时参数被错误拆开后,命令提示忽略 --include,但没有把这当成成功,而是回到模型目录核对实际文件。
我把模型单独放在 E:\Agent\Projects\MiniMax-H3\models,然后只在已有的 extra_model_paths.yaml 里追加一段:
1 | minimax_h3: |
已有的 qwen_image 段保留原样。这样两个项目共用 ComfyUI 运行环境,但模型文件、工作流、日志和输出目录各自管理。下载时我也逐个核对了模型文件字节数,而不是只看目录里有没有同名文件。
下载 19.5 GiB 的 DiT 权重时,hf download 有一次跑了 25 分钟,.incomplete 仍是 0 字节。同一地址的 Range 请求却能正常返回,说明当时卡在下载工具的连接上,不是模型文件不可达。我最后用 6 路分段下载器分别写入临时分片,支持中断续传,拼接后再核对目标字节数;完整文件花了约 80 分钟。这个过程比重试整条生成工作流快得多。
另一个小坑是 PowerShell 多行参数:最初用 --include 的命令只拉下了 14 个文件,漏掉了最大的 DiT。后来我检查实际文件清单和大小,并用明确的文件参数补齐。模型下载完之后,ComfyUI 启动日志和一次实际出片才共同证明各类权重都被识别。
CUDA 构建版本踩坑记录
虽然 ComfyUI 已经能找到 H3 节点,原来的 PyTorch 还是 2.11.0+cu128。启动日志显示 comfy_kitchen backend cuda 被标为 disabled: True。检查 ComfyUI 的 quant_ops.py 后发现,CUDA 版本低于 13 时,启动代码会禁用 comfy_kitchen 的 CUDA 后端;升级到 cu130 后,日志变成 disabled: False,并列出 INT8 等原生算子。对应源码
我在原虚拟环境里固定 PyTorch 和 torchvision 版本,只换 CUDA 构建:
1 | E:\Agent\Projects\ConfyUI\venv\Scripts\python.exe -m pip install ` |
升级后确认的关键日志是 pytorch version: 2.11.0+cu130、Device: cuda:0 NVIDIA GeForce RTX 5080,以及 CUDA backend 的 disabled: False。Comfy 的 H3 模型仓库也把 INT8 ConvRot 标为适合 cu130 的扩散模型格式。Comfy-Org/MiniMax-H3
这能证明加速后端已经启用,但我没有用相同提示词分别在 cu128 和 cu130 下做对照计时,所以不写一个未经本机验证的性能倍数。显卡能跑、权重能加载和某个算子确实被本次工作流使用,是三种不同的证据。
第一次出片,最后一步才报错
H3 的扩散和 VAE 都跑完后,第一次真实出片还是失败了。错误落在最后的 SaveVideo 节点:
1 | SaveVideo.execute() missing 1 required positional argument: 'format' |
奇怪的是,提交工作流时 ComfyUI 的 API 校验已经通过。为了不每次都等模型跑几分钟,我做了一个不加载 H3 的廉价探针:EmptyImage → CreateVideo → SaveVideo。把 8 种候选输入形状跑一遍后,发现 DynamicCombo 需要的是选项键字符串:
1 | { |
直接传嵌套字典,或者把输入写成 format.format 这样的点号键,都无法按预期映射到执行参数。改成字符串后,探针不到一秒就能验证保存节点,再运行完整模型才成功。
这次排查也给我一个很实际的提醒:API 的结构校验通过,不等于节点运行时拿到的参数形状正确。遇到这类错误,先把工作流缩到不加载模型的最小版本,试错成本会低很多。
把 H3 注册成 Harness 工具
MCP 配置用 stdio 启动本机 Python 虚拟环境里的服务。serverName 决定工具的名字前缀;COMFYUI_URL 指向视频实例的 8189 端口。视频生成时间比一次普通工具调用长得多,所以超时设为 45 分钟:
1 | - insert: |
示例里的磁盘路径需要换成本机实际位置。配置加载后,Harness 里出现四个工具:
| 工具 | 用途 |
|---|---|
generate_video |
按文字提示生成视频和音频 |
generate_video_i2v |
用首帧图片和提示词生成视频 |
h3_status |
查看 ComfyUI、权重、PyTorch 和显存状态 |
h3_free_vram |
请求两个实例释放已载入显存的模型 |
这是 DSH 的启动 overlay;新增或修改配置后需要重启 Harness,工具才会出现在新会话里。
--patch 的作用是把 MCP 工具注册到 Harness 会话,不会因此把模型提前装进显存。8188 的 Qwen 生图实例和 8189 的 H3 实例是两个进程,却共用一张 16 GB 显卡;H3 工具在提交生成任务前会请求 Qwen 实例卸载模型,让 H3 使用显存。进程仍然运行,下一次生图时再重新载入,代价是等待模型回到显存。
有个容易误判的细节:ComfyUI 的 POST /free 成功时会返回 HTTP 200,但响应 body 为空。如果 MCP 服务器接着把空字符串交给 JSON 解析,就会把成功误报成失败。
使用MCP stdio 实测生成了一条 832×480、56 帧、8 步的视频,用时 27.1 秒。之后的 Harness 会话也实际触发了工具、生成并展示了视频,后面三段样片就是从本地 H3 实例生成的。
速度和显存:分辨率上去,等待时间也上去
RTX 5080 16 GB 上的几次测试如下。三条主要数据来自 5 秒请求;768p 是 1344×768,480p 是 832×480。
| 设置 | 提交到出片 | 说明 |
|---|---|---|
| 480p,20 步 | 110.2 秒 | 常规采样 |
| 768p,20 步 | 510.9 秒 | 原生 768p 画布 |
| 480p,6 步 + Turbo LoRA | 50.1 秒 | 快速预览 |
| MCP 测试:480p,约 2.33 秒,8 步 | 27.1 秒 | 56 帧,stdio 真实出片 |
前两项是在模型已载入后的热跑;第一次冷启动还要增加约 1–2 分钟的模型加载时间。像素数变为约 2.5 倍,20 步测试耗时从 110 秒增加到 511 秒。分辨率、时长和步数都会影响等待时间,Turbo 预览适合先看大方向,不能把它的速度直接当成高步数成片的速度。
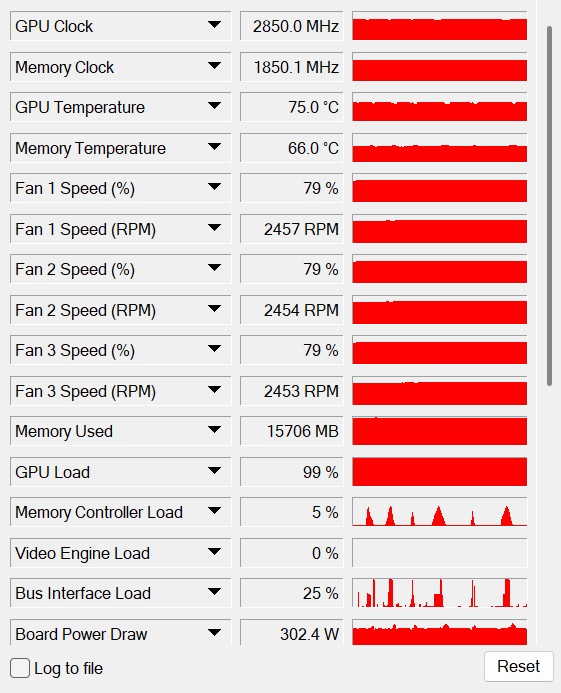
768p 推理期间,每 5 秒采样一次,显存峰值为 15,743 / 16,303 MiB(96.6%),系统内存占用峰值约 32.5 GB / 64 GB。H3 的 DiT 权重大于显卡显存,日志显示 ComfyUI 把约 19,995 MB 的模型 staged 到 dynamic VRAM 路径。
三段本地生成的视频
第一条是白色鹈鹕骑着红色复古自行车,篮子里装着鱼,沿海边木栈道前进。这条 768p 样片使用 Turbo LoRA、6 步,生成耗时约 173 秒。成片是 1344×768、24fps、124 帧,时长 5.167 秒;我从头到尾看下来,场景和主角都比较完整。

第二条是暴风雨前后的海边灯塔,浪打在岩岸上。它同样是 1344×768、24fps、124 帧,时长 5.167 秒,也有 AAC 立体声轨。
第三条是雨天桥上的多镜头片段,画面在城市远景、黄色雨衣和红色保温杯的特写之间切换。它长 8 秒,有 192 帧,视频和音频编码规格与前两条相同。
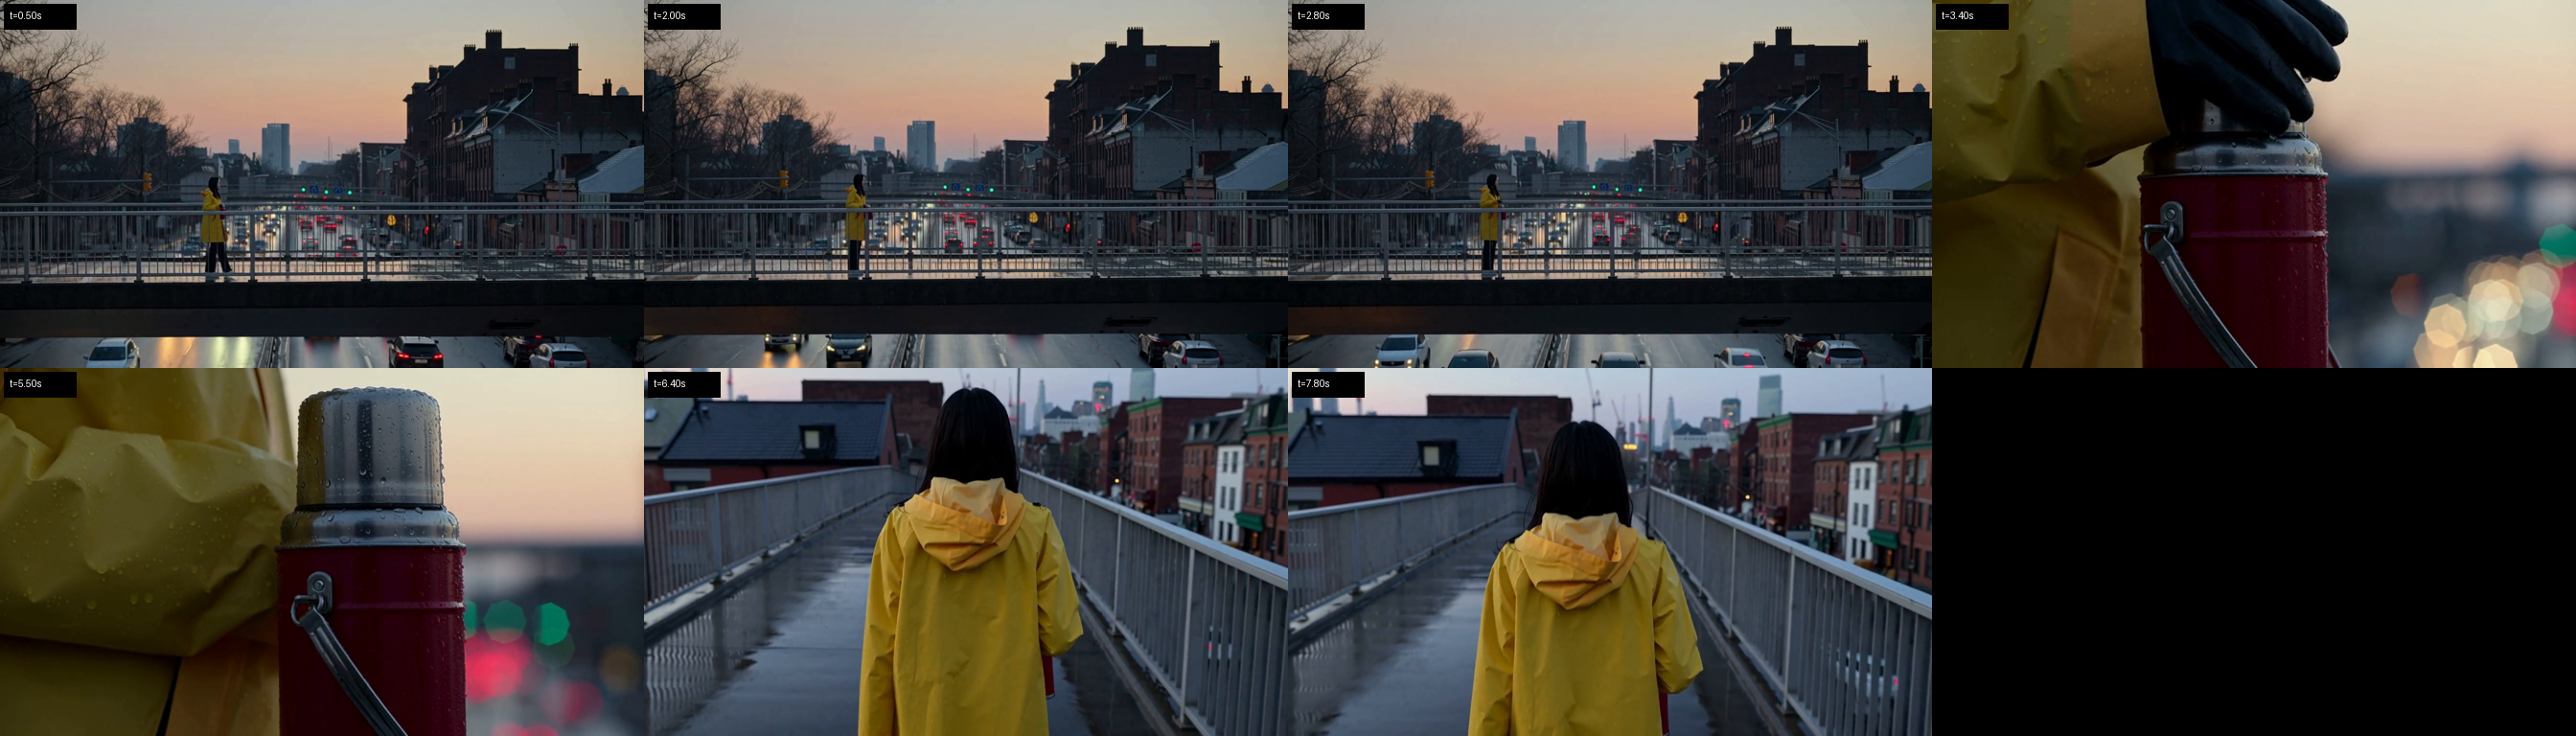
这三条 MP4 都经媒体探测确认有 H.264 视频流和 AAC 32 kHz 双声道音轨。探测到音轨只能说明文件里有音频及其编码信息,不能替代对声音内容和音量的主观检查。
结尾
这次完成的是本机 ComfyUI 上 H3-Base FL2VA 的短视频生成,再通过 MCP 让 DeepSeek Harness 以工具方式发起任务。16 GB 显卡可以通过量化权重和 dynamic VRAM 跑出 768p 视频,不过单条 20 步样片要等几分钟,显存和系统内存都接近高位;如果希望快速确认提示词方向,480p Turbo 预览更合适。
本机实测走到 768p。MiniMax 当前文档中的完整 2K 路线还组合了托管的 H3-Context-IR 与 H3-Regenerate-2K 阶段;这篇记录没有部署或验证那条链路。官方工作流说明对本地 H3-Base 和完整 2K 流程分别说明。
还有许可证问题。MiniMax H3 Community License 当前文本列出适用地区的排除范围,并对商业产品和服务写有额外条件;ComfyUI 的 H3 教程则称本地生成结果用于商业用途需要相应许可。两处说明不宜被压成一句“可以商用”或“只能非商用”,实际使用前应分别阅读模型许可证和ComfyUI 官方教程,按自己的部署和用途核实。
如果我还要继续调提示词,会先用 480p Turbo 看动作和构图方向,再跑 768p 成片。没准2027年个人可以实现生图生视频自由,显然短剧的春天已经到来了~