在 Windows 本地部署 Qwen-Image-2.1:接入 DeepSeek Harness 的生图与改图实践
目录
实现思路:Qwen-Image-2.1 在本机 ComfyUI 里运行,再通过 MCP 服务接入 Harness。验证下来,DeepSeek v4 不必先看懂图片:它可以把路径和修改指令交给图像模型处理。缺点是它无法检查生成结果,也不能判断柯基有没有保留、雪景是否符合预期。
如何选择模型版本?
机器配置是 Windows 11、Ryzen 9 9950X3D、64GB 内存和 RTX 5080 16GB。先看模型文件就能发现显存不够宽裕:Qwen-Image-2.1 的扩散模型 BF16 权重约 14.23GB,文本编码器 Qwen3-VL-8B 的 int8 文件约 9.35GB,另外还要加载 VAE。推理时还要给编码、采样和中间张量留空间,所以 BF16 全套权重不是这张卡能直接承载的方案。
最终选用社区发布的 Q5_K_M GGUF 扩散权重,文件约 5.22GB;文本编码器用 int8 版本,VAE 保留 BF16,约 676MB。这个组合是在当前显存下兼顾量化档位和文件体积的折中,不代表它在其他显卡或工作流里也是最佳选择。
GGUF 也决定了运行栈。diffusers 不能直接加载这份 GGUF 扩散权重,因此改用 ComfyUI 加 ComfyUI-GGUF 节点。最初试 city96 分支时,加载 Qwen-Image-2.1 报 Unknown model architecture!;换到 leejet 分支后才成功加载。
RTX 5080 属于 Blackwell,PyTorch 需要带 Blackwell 支持的 CUDA 构建;这里使用 PyTorch cu128(CUDA 12.8)。模型文件和 ComfyUI 运行目录分开放后,还要在 extra_model_paths.yaml 里把权重目录映射给 ComfyUI:
1 | qwen_image: |
安装时,ComfyUI 本体和 ComfyUI-GGUF 节点分别准备,PyTorch 使用 CUDA 12.8 轮子;节点还需要 gguf、sentencepiece 和 protobuf。MCP 服务也放进同一个虚拟环境,确保 DSH 拉起服务时能找到对应的 Python 包:
1 | python -m venv venv |
上面省略了 ComfyUI 和 leejet/ComfyUI-GGUF 的 clone 命令及常规安装步骤。实际排查下来,节点分支、CUDA wheel 和 MCP 包版本都要与这套工作流匹配。
下载模型时遇到过 Xet 返回 CAS Client Error: File reconstruction error。关闭 Xet、把 worker 限制为一个之后,文件才下载完成:
1 | $env:HF_HUB_DISABLE_XET = "1" |
报错出在下载链路,不是 GGUF 模型本身。遇到同样的错误,可以先关闭 Xet,再用单 worker 重试。
ComfyUI 做执行端,Harness 做入口
ComfyUI 监听本机 127.0.0.1:8188。MCP 服务不加载模型,也不执行采样;它接收 Harness 的工具调用,把参数填进 ComfyUI API 工作流,提交任务、等待完成,再把输出图片路径返回。调用关系如下:
1 | DeepSeek Harness / DeepSeek v4 |
MCP 服务通过 /prompt 提交 ComfyUI API 工作流,再轮询 /history 获取执行结果。generate_image 接收提示词和尺寸等参数;edit_image 则先把输入图片复制到 ComfyUI 的 input/ 目录,再把图片文件名交给工作流。
我第一次走 API 工作流时,TextEncodeQwenImage21 明明在节点界面显示了 resolution 默认值,提交后仍报 Required input is missing: resolution。我在文生图和改图工作流里都显式传入 resolution,这个错误才消失。
通过 MCP 工具接入 DSH
Harness 通过 @deepseek-ai/dsh-mcp-client 注册 stdio MCP 服务。配置里的路径要换成实际安装位置;command 指向装好 ComfyUI/MCP 依赖的 Python,args 指向 MCP 服务文件:
1 | - insert: |
生图不会马上返回,因此工具超时设为 300000 毫秒。MCP Python 包的版本也需要留意:这份服务用 FastMCP 接口,最初安装 2.x 时,启动报错 No module named 'mcp.server.fastmcp'。改用 mcp<2 后服务正常启动。这个约束针对当前实现,不是说所有 MCP 服务都必须使用 1.x。
通过 dsh web --patch <配置文件> 加载配置时,先停掉原实例、带 --patch 重启后,MCP 工具也不会立刻出现;等发现完成,新会话里才会列出 mcp__comfyui__generate_image 和 mcp__comfyui__edit_image。
文生图:工具提交的是一份工作流
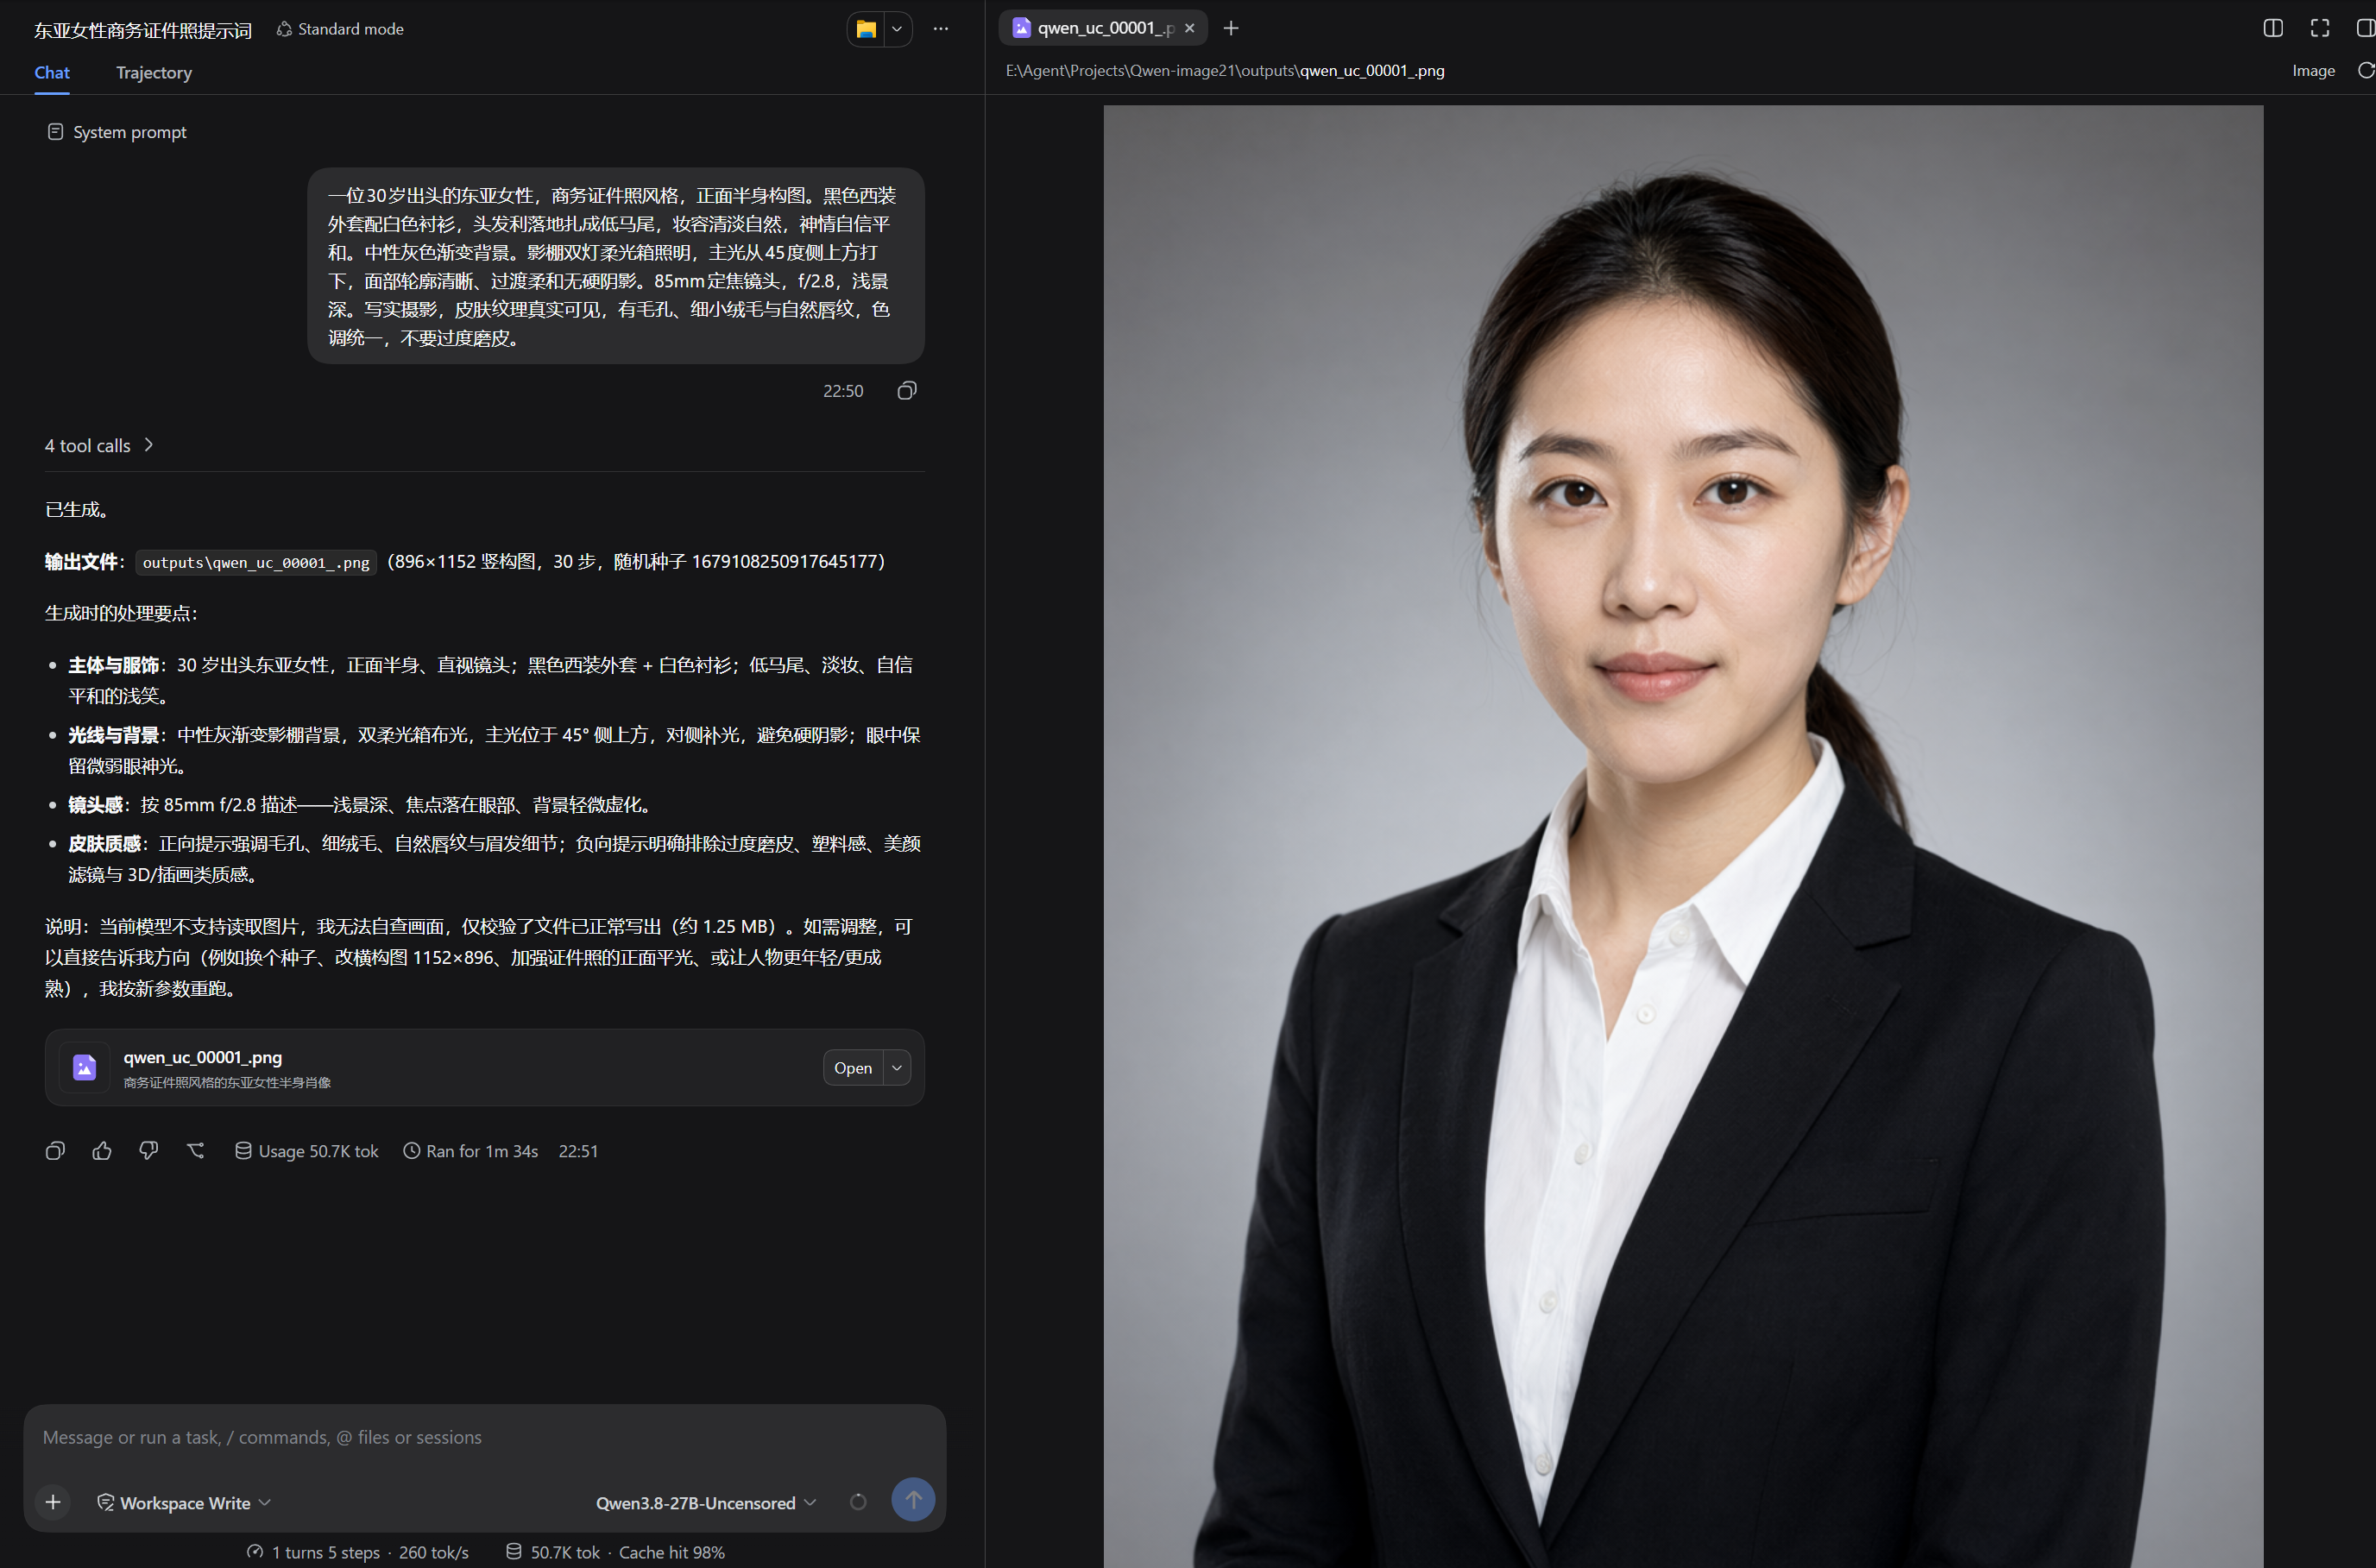
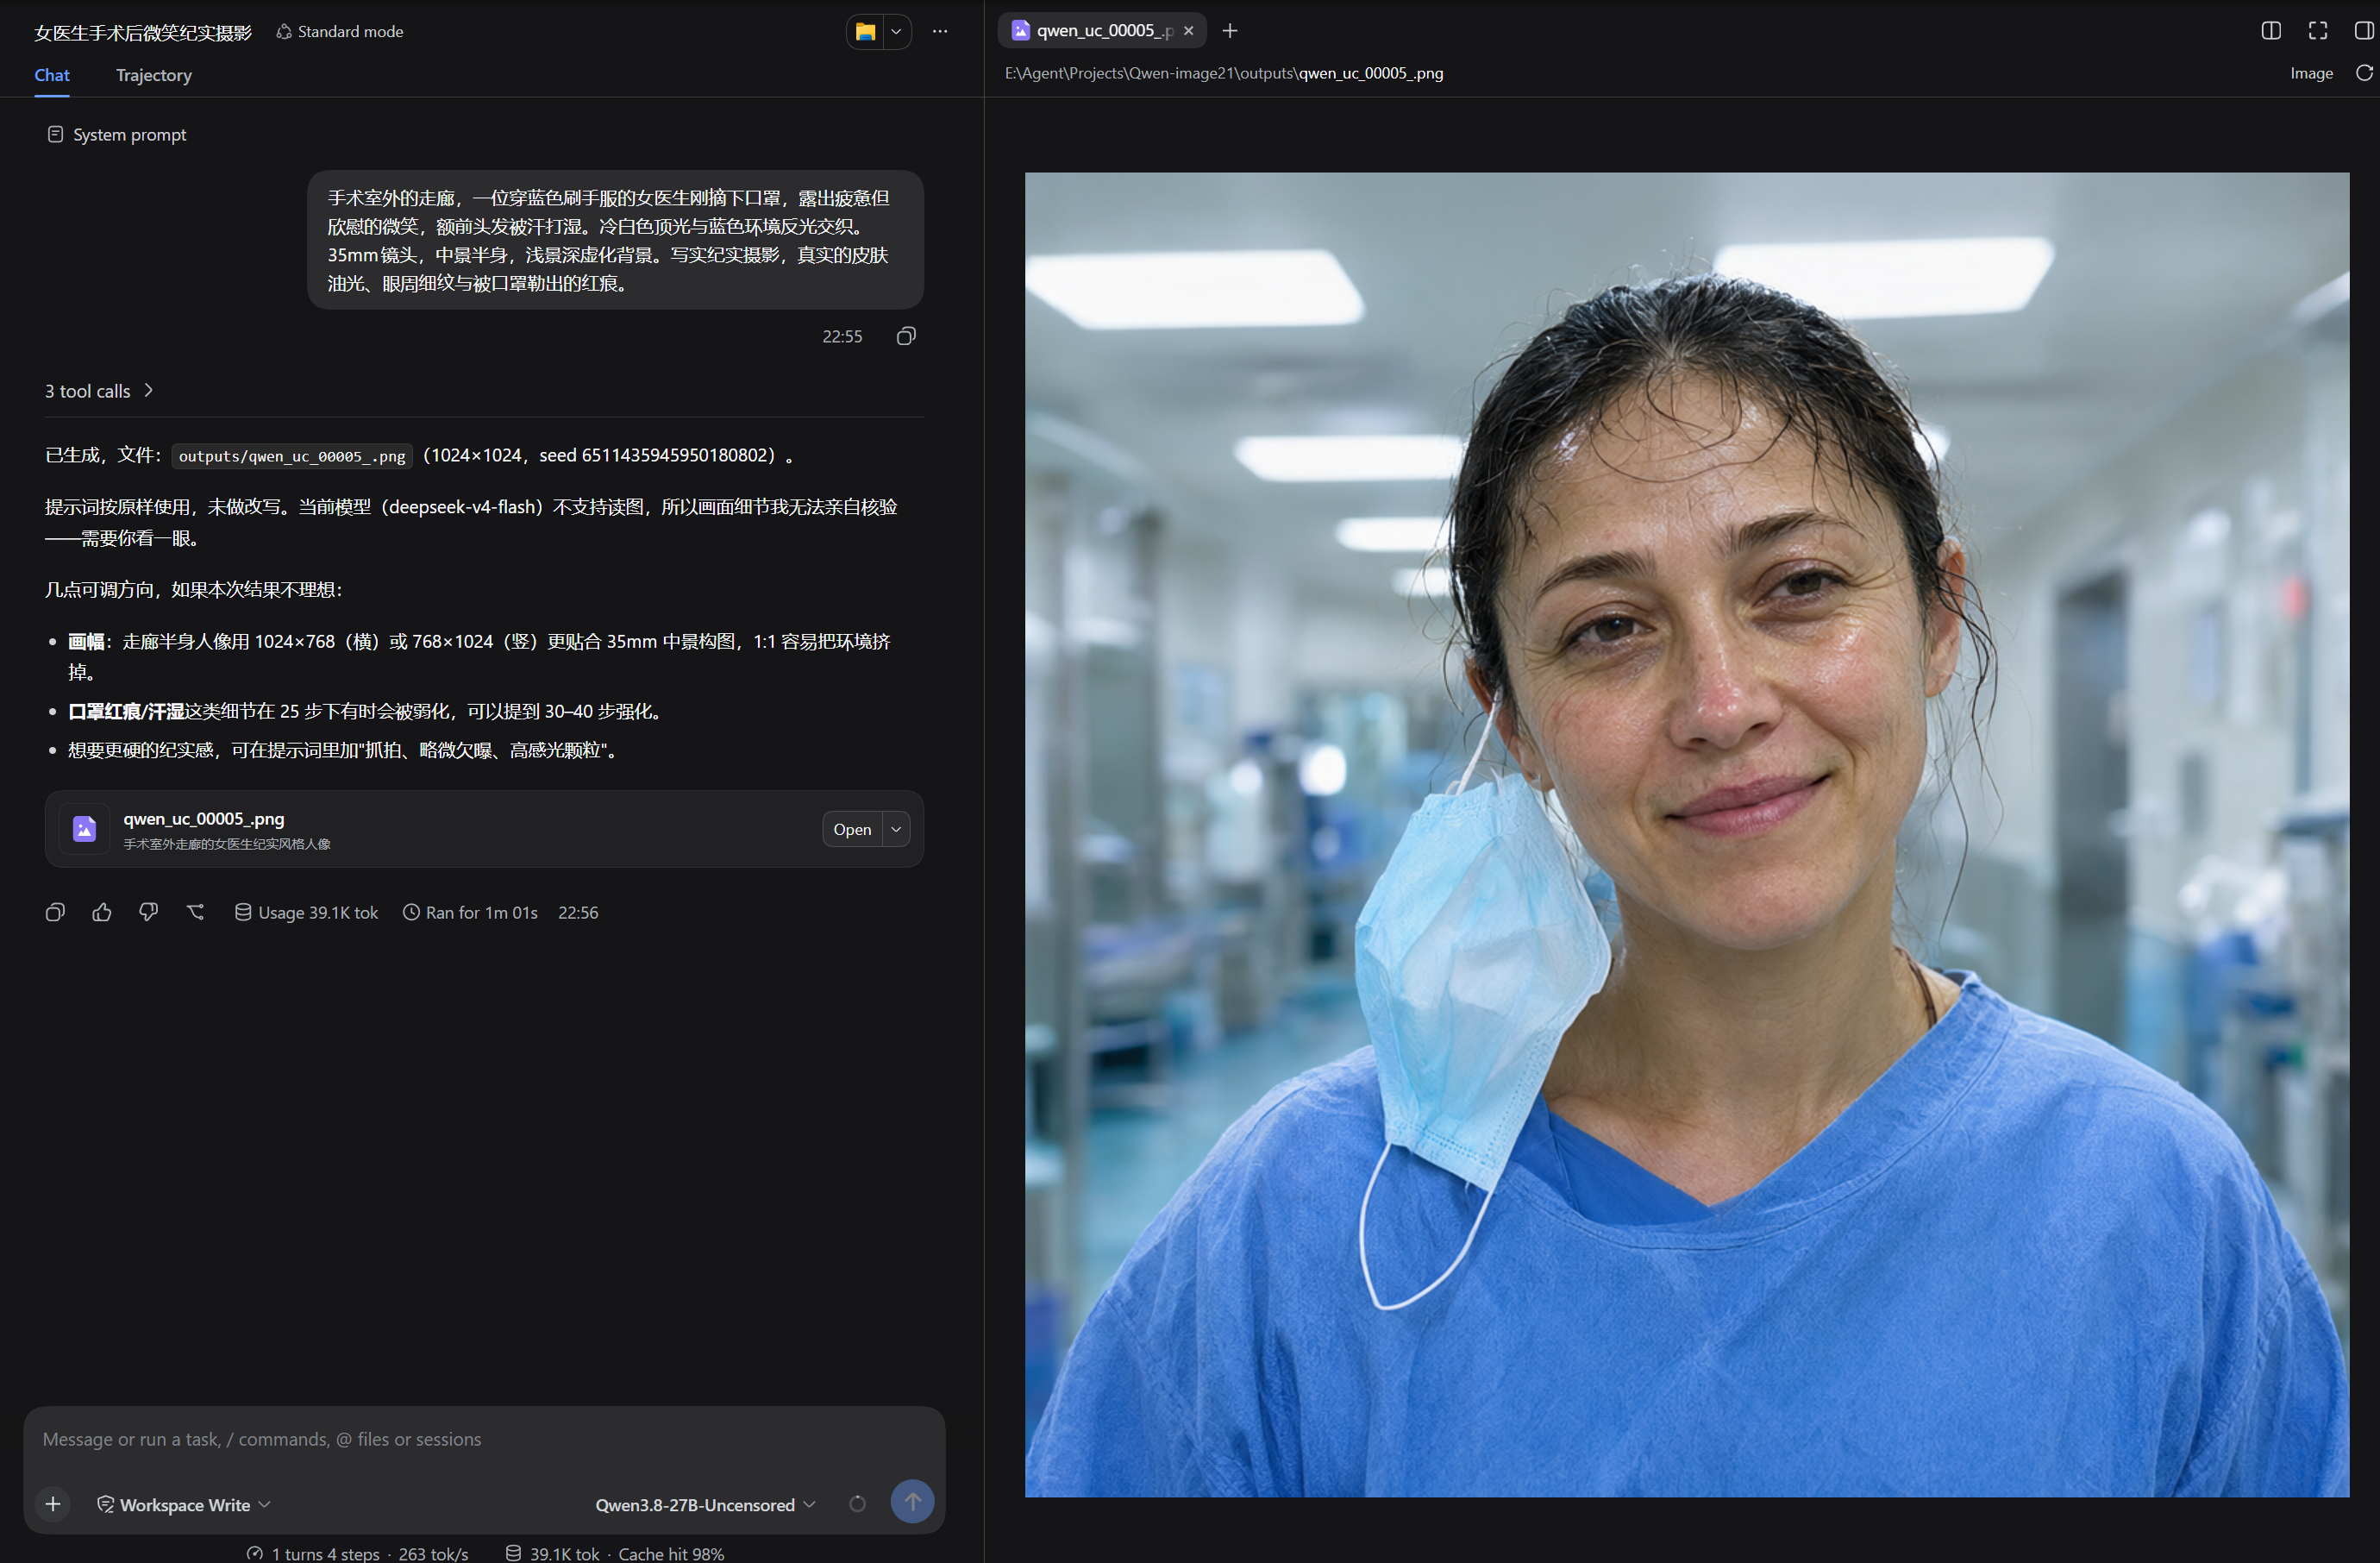
generate_image 收到提示词、宽高、步数、seed 等参数后,构造一份 ComfyUI API 工作流。文生图的节点大致是:GGUF 扩散模型、Qwen Image 文本编码器、VAE、提示词编码、空 latent、KSampler、解码和保存。MCP 服务提交工作流并等待 ComfyUI 返回结果路径;Harness 再把路径作为工具结果展示。
关于改图
实现一个 edit_image (MCP工具调用),用于接收 image_path 和修改提示词。MCP 服务先检查路径,再把图片复制到 ComfyUI 的 input/ 目录,避免工作流引用 ComfyUI 读不到的位置。随后工作流用 LoadImage 读入图片,把图像与 VAE 一起传给 TextEncodeQwenImage21。如果提示词里没有 <image1>,工具会自动补上这个参考图标记。
这条工作流使用 denoise=1.0,不是通过降低 denoise 来尽量保留原 latent 的轻量 img2img 调法。参考图作为条件进入 Qwen-Image-2.1,再由采样器完成生成。工具能接到图片并产出新图,不等于图片细节一定按要求保留,结果仍需打开检查。
这也回答了开头的问题:DeepSeek v4 看不到图,仍然可以发起编辑,因为它能把附件路径和文字指令交给 edit_image。之后由 ComfyUI 读取图片,再交给 Qwen-Image-2.1 生成;图片内容没有送进文本模型。
不过 DeepSeek v4 也看不到输出图,没法自动确认柯基是否保留、雪景是否符合指令。这次验证到的是路径传递和工作流执行成功,结果是否满意仍需人工检查。若要让 Agent 自己比较输入和输出,还得再接一个能看图的模型。
结尾
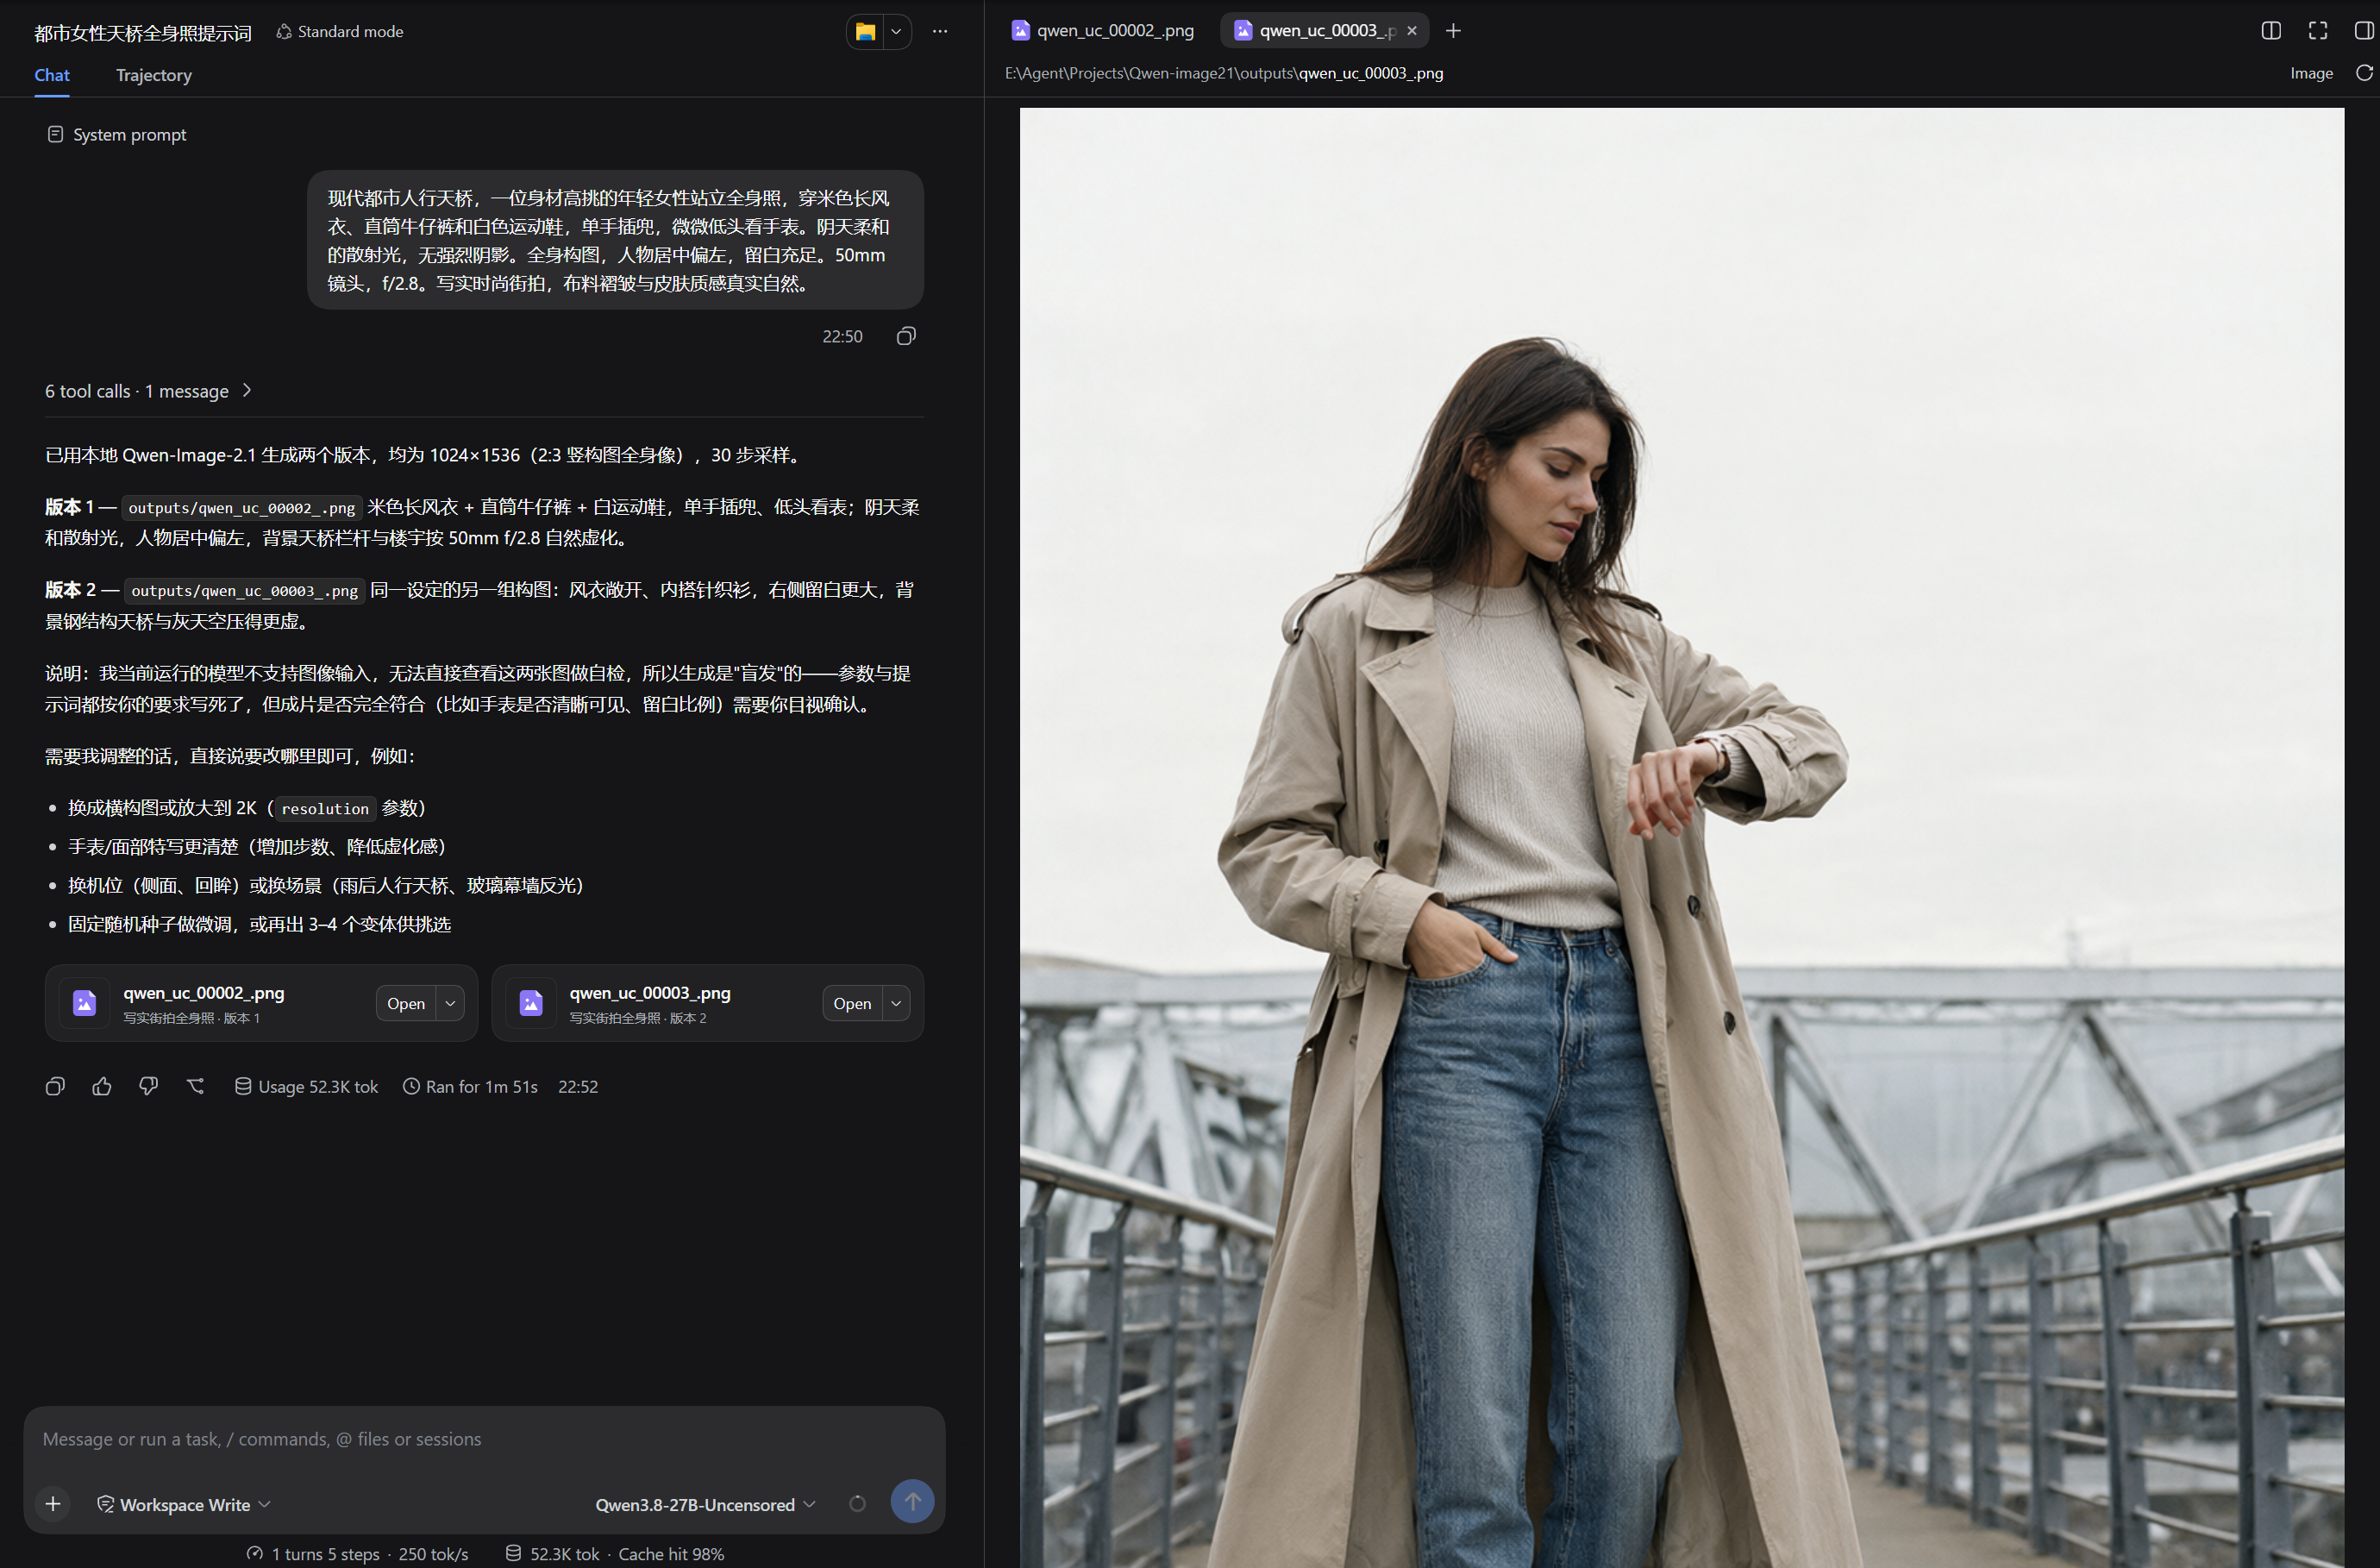
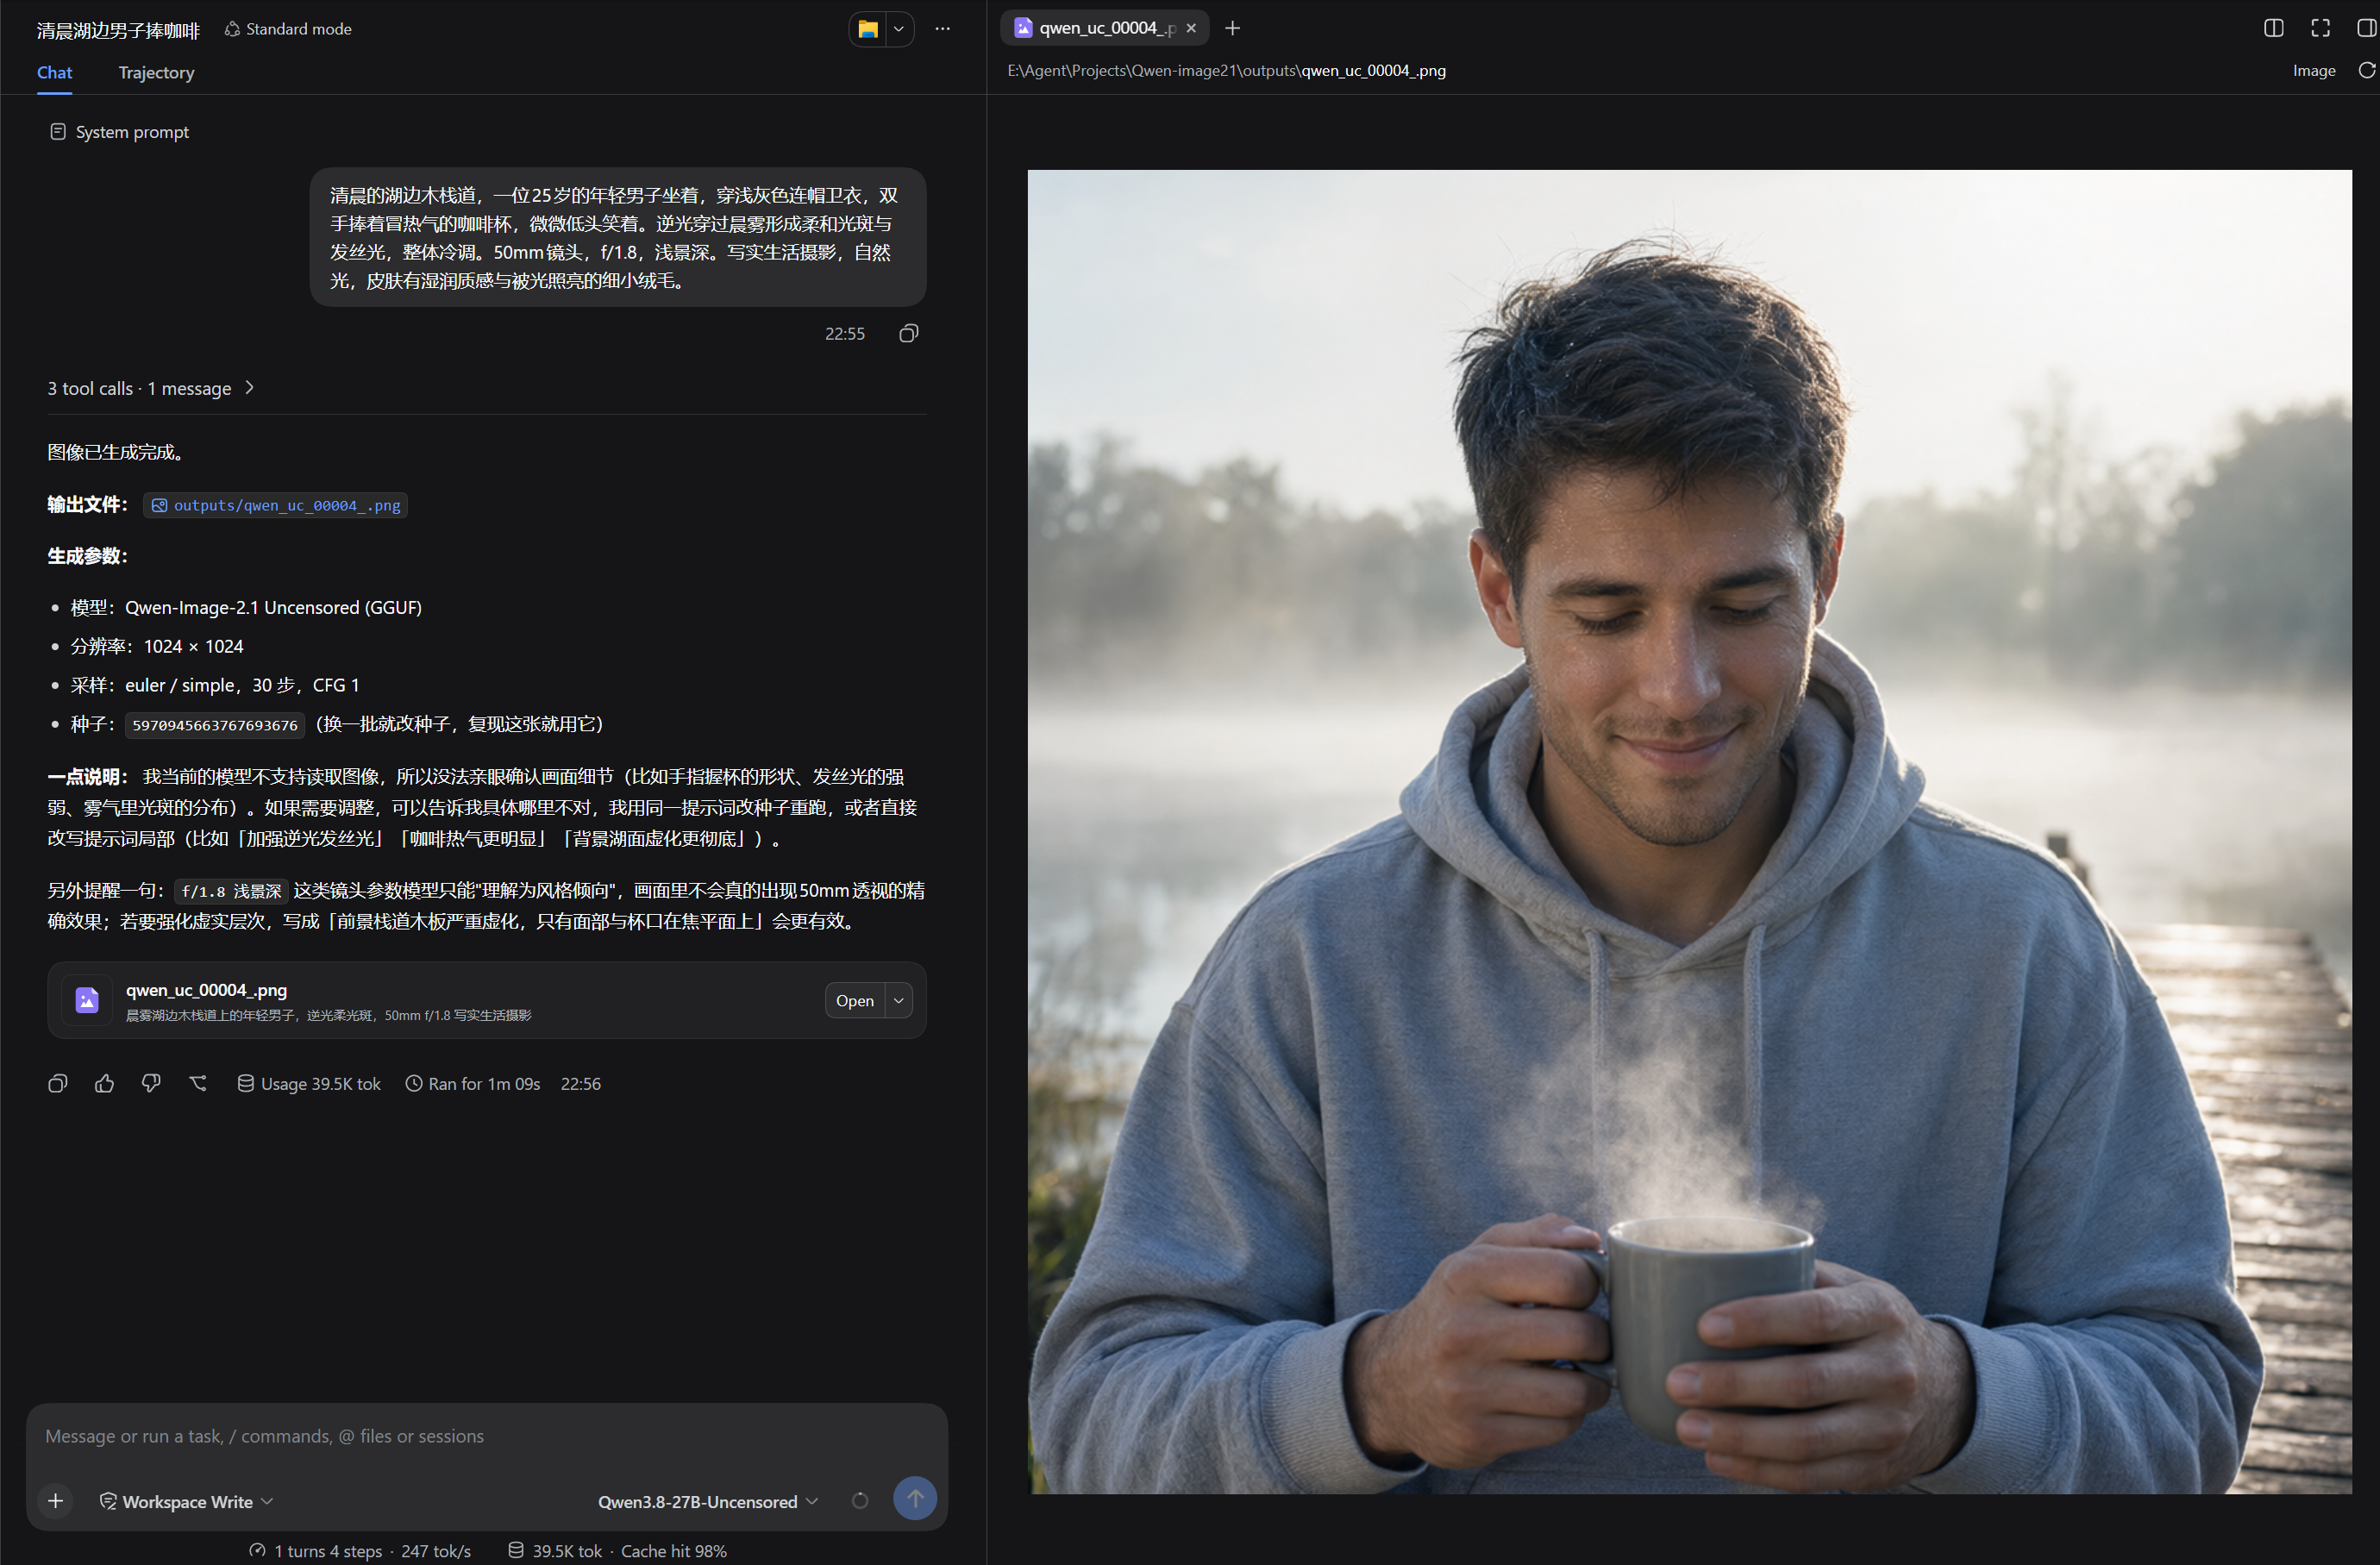
实际验证包括 Q5_K_M 文生图、柯基图片改成雪夜的 edit_image 调用、MCP stdio 握手与工具调用,以及 ComfyUI 启停脚本。样例图尺寸不完全相同:截图里分别有 896 × 1152、1024 × 1024 和 1024 × 1536,展示图的采样步数为 30。
生成完成后,显存占用约 13.5GB,空闲约 2.4GB。单张、1024 级别的工作流能跑通,余量却不多;更高分辨率、批量任务和其他节点组合尚未验证。尝试这类负载时,可以考虑 offload 或更低量化,但当前结果不能证明 2K 或并发任务也能稳定运行。
实际使用的不是官方发布的完整权重,而是社区整理的 Qwen-Image-2.1 Uncensored GGUF,它基于官方 Qwen-Image-2.1 做了衍生处理和量化。官方基础模型页面列出 Qwen Research License,许可文件对非商业用途有约束;商业使用需按许可要求另行申请。使用社区版本前,还要单独核对衍生仓库的许可,不能只凭“能下载、能本地运行”推断可以商用。