在 Windows 上部署本地模型:接入 DeepSeek Harness 的完整实践
目录
先确认模型格式
最初看到的是 orcarouter/Qwen3.8-27B-Uncensored-MLX。MLX 版本适合 Apple Silicon,原仓库的安装方式也围绕 mlx-vlm 展开。但我的目标机器是 Windows + NVIDIA 显卡,因此MLX版本不适用。
于是下载了 bartowski/orcarouter_Qwen3.8-27B-Uncensored-GGUF,是一个破甲版本,会少一些限制。GGUF 可以交给 llama.cpp 加载,Windows 也有对应的 CUDA 构建版本。模型格式换好,接下来就看它能不能在这张 16GB 显存的卡上跑起来了。
机器配置与量化选择
机器配置如下:
| 项目 | 配置 |
|---|---|
| 系统 | Windows 11 24H2 |
| CPU | AMD Ryzen 9 9950X3D,16 核 32 线程 |
| GPU | NVIDIA GeForce RTX 5080,16GB GDDR7,Blackwell sm_120 |
| 内存 | 64GB |
| llama.cpp | nightly b10985,CUDA 13.4 |
RTX 5080 的 16GB 显存,很快就成了量化档位的边界。
| 量化 | 文件大小 | 实际情况 |
|---|---|---|
| Q4_K_M | 约 17.77GB | 质量和大小看起来合适,但超过显存容量 |
| Q4_K_S | 约 16.71GB | 仍然偏大 |
| IQ4_XS | 约 15.57GB | 可以尝试完整放进显存 |
| Q3_K_M | 约 14.61GB | 更容易装下,但量化档位更低 |
这里的 GB 容易产生误会。Hugging Face 页面使用十进制 GB,PowerShell 里的 1GB 按 GiB 计算,所以同一个文件在两个地方显示的数字会有差异。判断量化是否适合时,我主要看它能不能给模型权重、mmproj 和 KV cache 留出空间。
这时有两个选择:继续用 Q4_K_M,让一部分层落到 CPU;或者换小一档的量化,尽量把权重留在 GPU。第一版我选择了前者,先把部署过程走通。
用 llama-server 提供本地接口
这次使用 llama.cpp 的 llama-server。它启动后提供 OpenAI 兼容 API,地址是:
1 | http://127.0.0.1:8080/v1 |
模型服务独立运行,DeepSeek Harness 只负责发请求、展示对话和执行工具。这样出现问题时,可以分别检查服务端、接口请求和 Harness 任务,这样可以把harness和模型服务解耦。
第一版 Q4_K_M 的启动参数如下:
1 | llama-server.exe ` |
-ngl 50 会把 50 层放到 GPU,剩余层交给 CPU。Qwen3.8-27B 一共有 64 层,所以这里大约有 14 层需要 CPU 参与计算。
这个参数能让 Q4_K_M 在显存不足时启动起来,但启动成功还不能说明交互速度可以接受。接下来要把它接进 Harness,再用实际任务测一次。
在 DeepSeek Harness 中添加模型
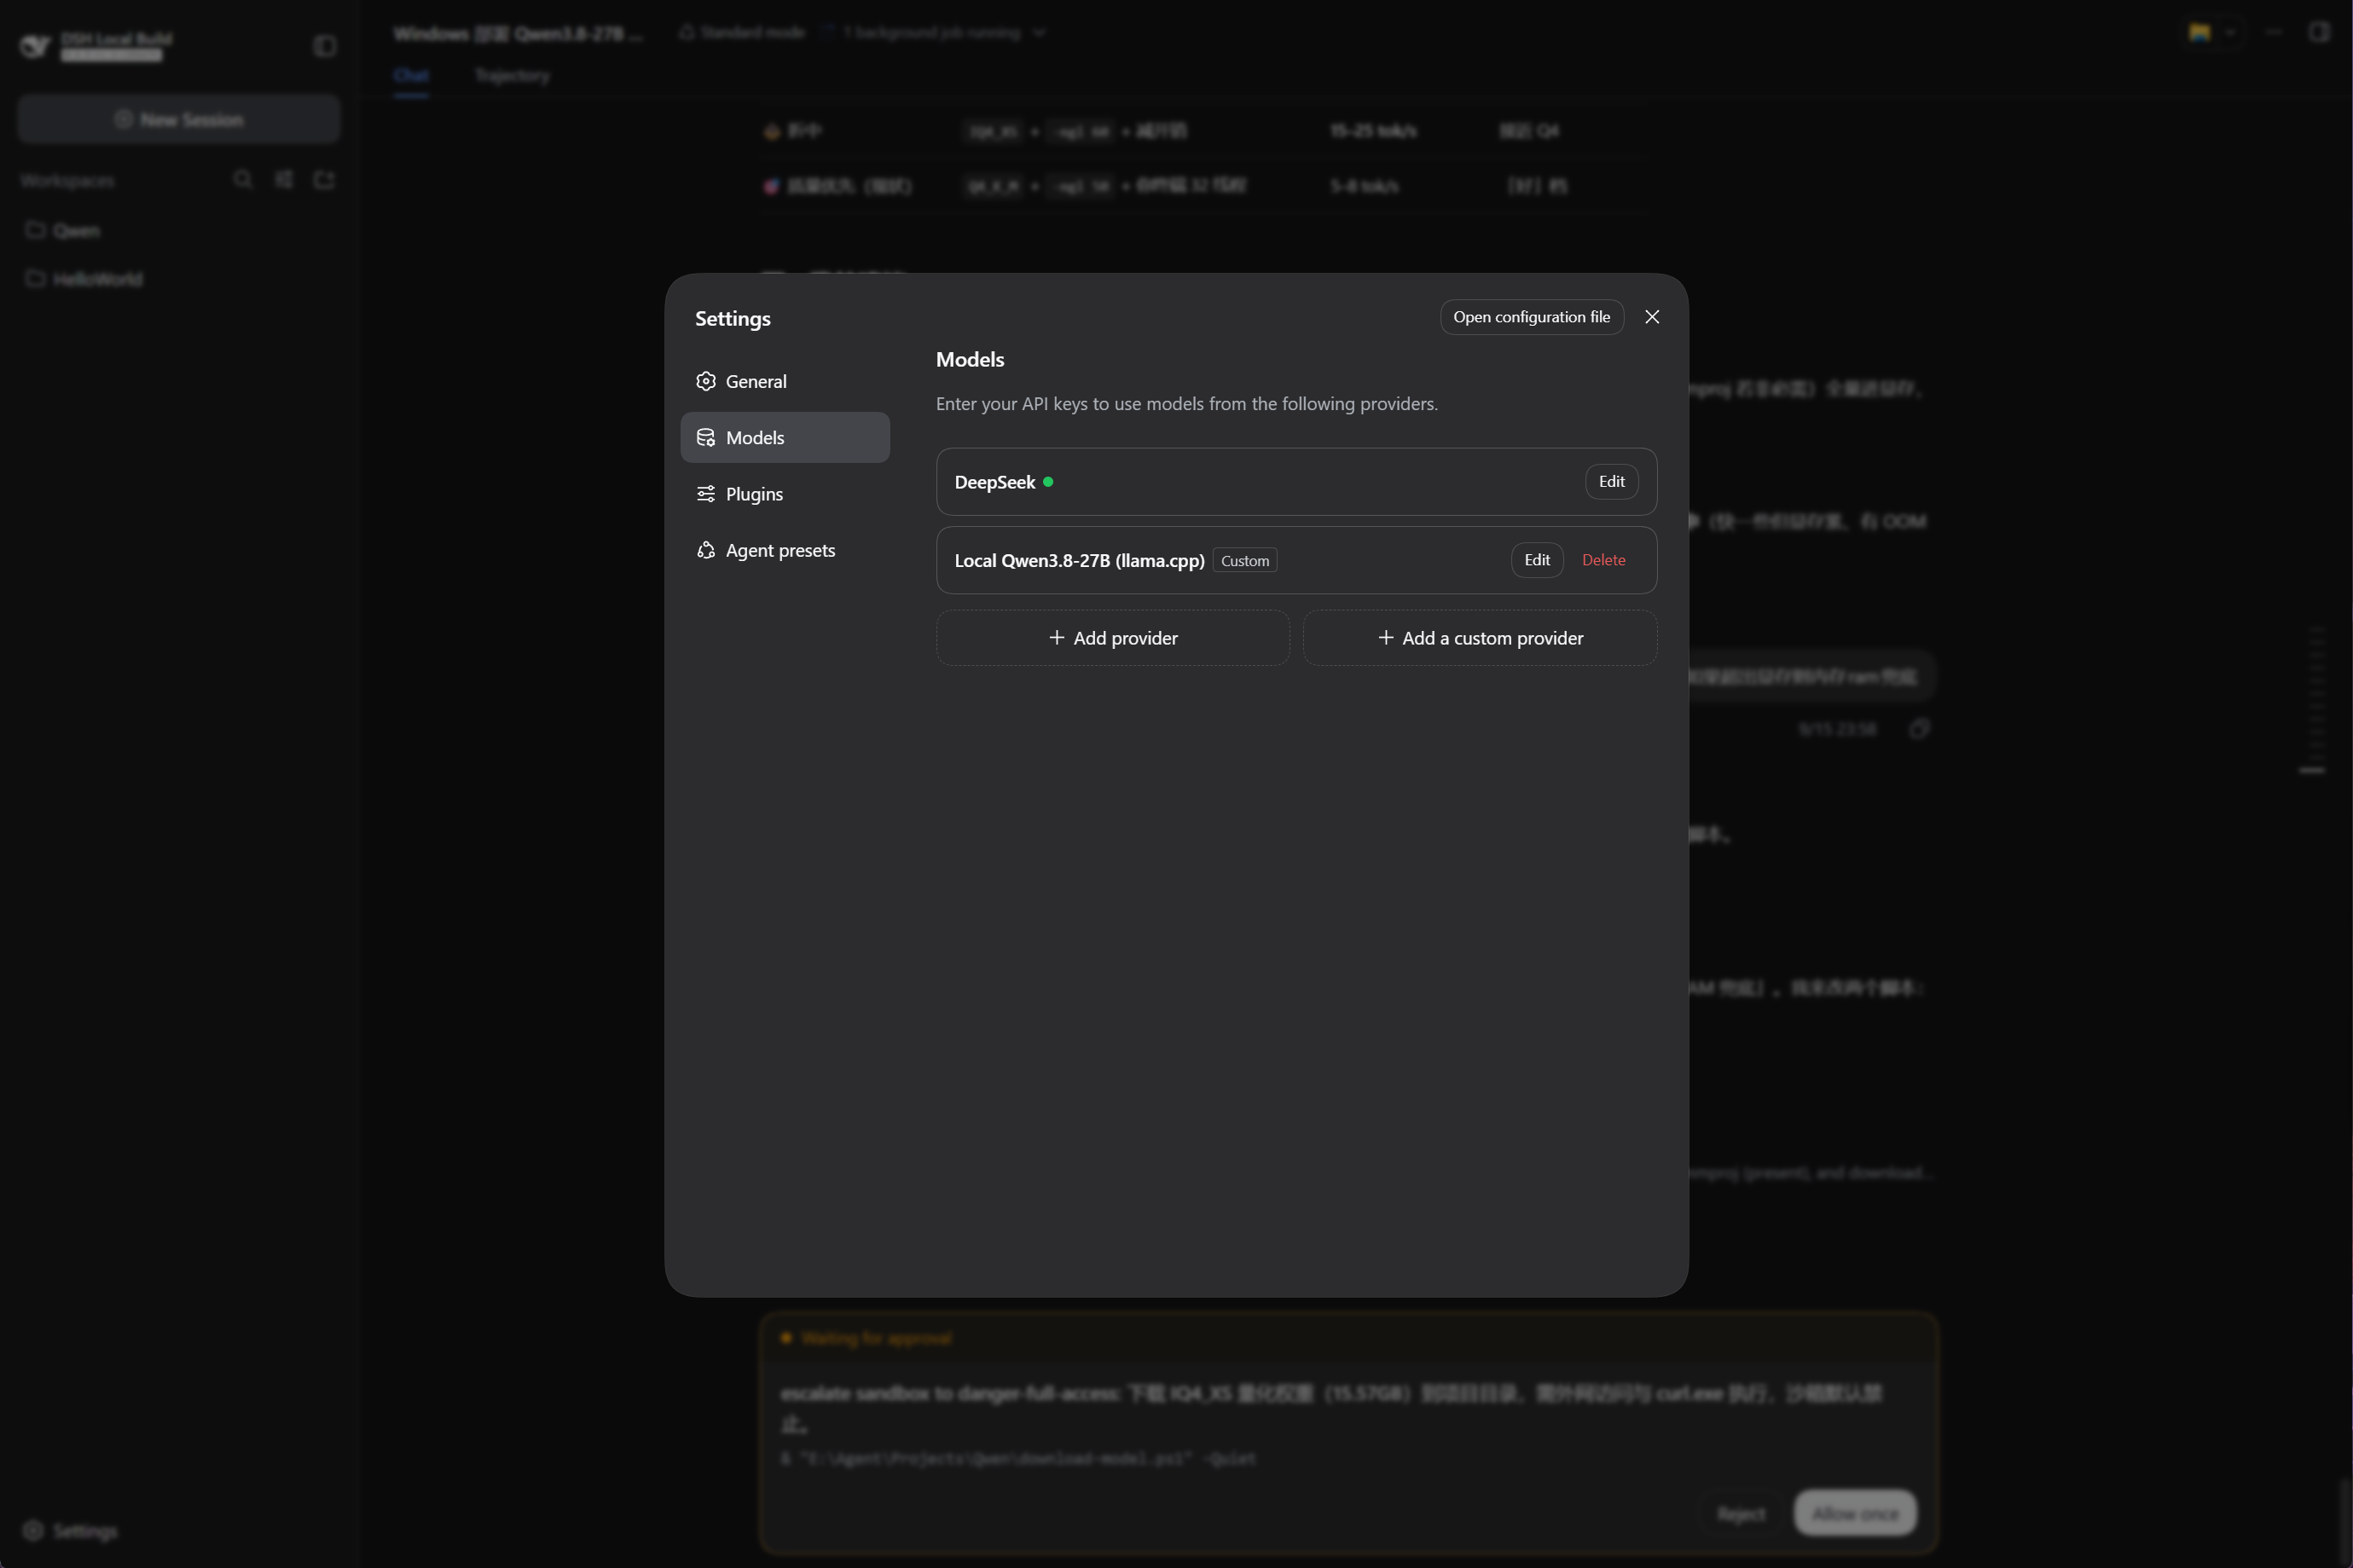
DeepSeek Harness 的入口是“设置 → 模型 → 添加自定义提供方”。自定义 Provider 的字段说明可以参考 Model Providers 文档。写入 C:\Users\Administrator\.dsh\settings.yaml 的配置片段如下:
1 | llm-pi-ai: |
id 要和 llama-server 的 --alias 一致。协议使用 openai-completions,因为 llama-server 提供 Chat Completions 接口。
supportsDeveloperRole: false 会让 Harness 使用 system 角色发送系统提示词;maxTokensField: max_tokens 则把请求字段改成 llama.cpp 能识别的名称。两个兼容性选项都和后端协议有关,填错以后,模型可能出现在列表里,但真正发送请求时仍然失败。
凭据这里使用 Authorization: Bearer local 作为占位值。服务只监听本机地址,主要作用是满足客户端的请求格式。
配置完成后,模型已经出现在 Harness 的模型列表中:
Q4_K_M:显存满了,速度却只有 1 tok/s
接入完成后,先用 Q4_K_M 发起请求,服务端能返回内容,Harness 也能继续工作,但输出速度大约只有 1 tok/s。另一轮服务端 timing 记录为 2.15 tok/s,150 个 token 用了约 76 秒。两轮测试的速度都没有达到交互使用的要求。
请求任务运行过程中GPU性能数据如下:显存使用约 15801MB,GPU Load 约 77%,总线利用率 100%。
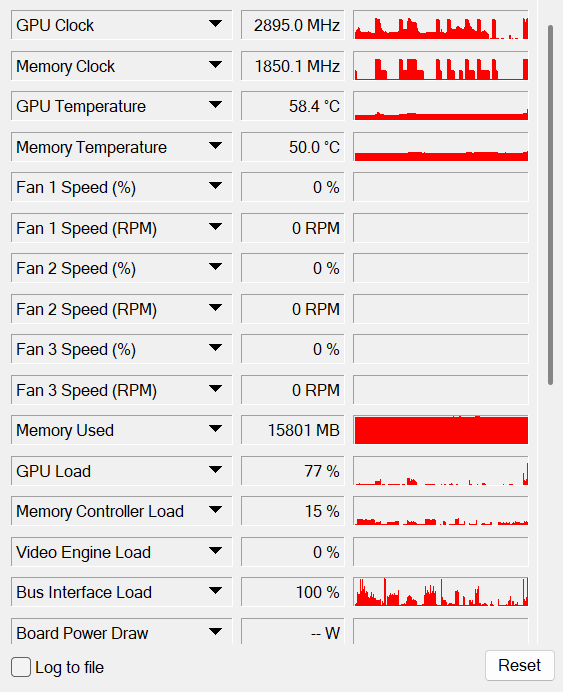
第一反应很容易是 CUDA 没有生效,但显存占用和 GPU 利用率已经说明 GPU 在计算。继续看 llama.cpp 的日志,才发现问题在另外一处:
1 | prompt eval time = 2273.54 ms / 57 tokens (39.89 ms per token, 25.07 tokens per second) |
MTP 的接受率超过 70%,说明投机解码确实在工作;但 eval 速度仍然很低,而且 CPU 线程池只有 8 个线程。
Q4_K_M 文件约 17.77GB,而显存只有 16GB。-ngl 50 让 50 层在 GPU,剩下约 14 层在 CPU。逐 token 解码时,每一轮都要经过这些层,GPU 处理完自己的部分后,必须等 CPU 完成剩余部分,下一轮才能继续。
于是出现了图 2 中的状态:GPU 负载很高,显存也接近占满,但整体速度被 CPU 层卡住。系统内存只是把放不下的权重接了过去,计算速度仍然按 CPU 的速度走(这里已然是瓶颈)。
尝试 IQ4_XS
Q4_K_M 已经证明,继续减少 -ngl 只会让更多层交给 CPU。虽然Q3_K_M 更容易装入显存,但还是希望尽量保留 Q4_K_M 的输出质量,于是换成 IQ4_XS。
第二版使用 --fit on,让 llama.cpp 按当前显存自动安排层数,同时限制单并发槽:
1 | $Quant = 'IQ4_XS' |
这里几个参数各自解决一个问题:
IQ4_XS把模型文件压到约 15.57GB,给其他显存开销留出空间。--fit on根据可用显存自动安排层数,避免手工固定-ngl。--fit-target 512预留 512MiB 的显存余量。-np 1只开一个并发槽,减少 KV cache 对显存的占用。
调整后显存占用约 15411MiB,模型基本可以全量留在 GPU。部署记录中的两次服务端测速为:解码 30.13 tok/s 和 20.90 tok/s,预填充 75.19 tok/s 和 54.41 tok/s。
这里的速度比第一版好很多,但它仍然只是 llama.cpp 的 timing。Harness 的一次任务还要加上上下文注入、思考、文件操作和工具调用,所以再做一次端到端对比。
冒泡排序任务:13min VS 53s
让模型在 Harness 中生成一个 1–10 的冒泡排序 Python 文件,并运行它。这个任务很小,代码也不复杂,但会经过完整的 Agent 流程:模型生成代码,Harness 写入文件,再执行并展示结果。
先用 Q4_K_M 跑这项任务,Harness 显示耗时约 13 分钟:
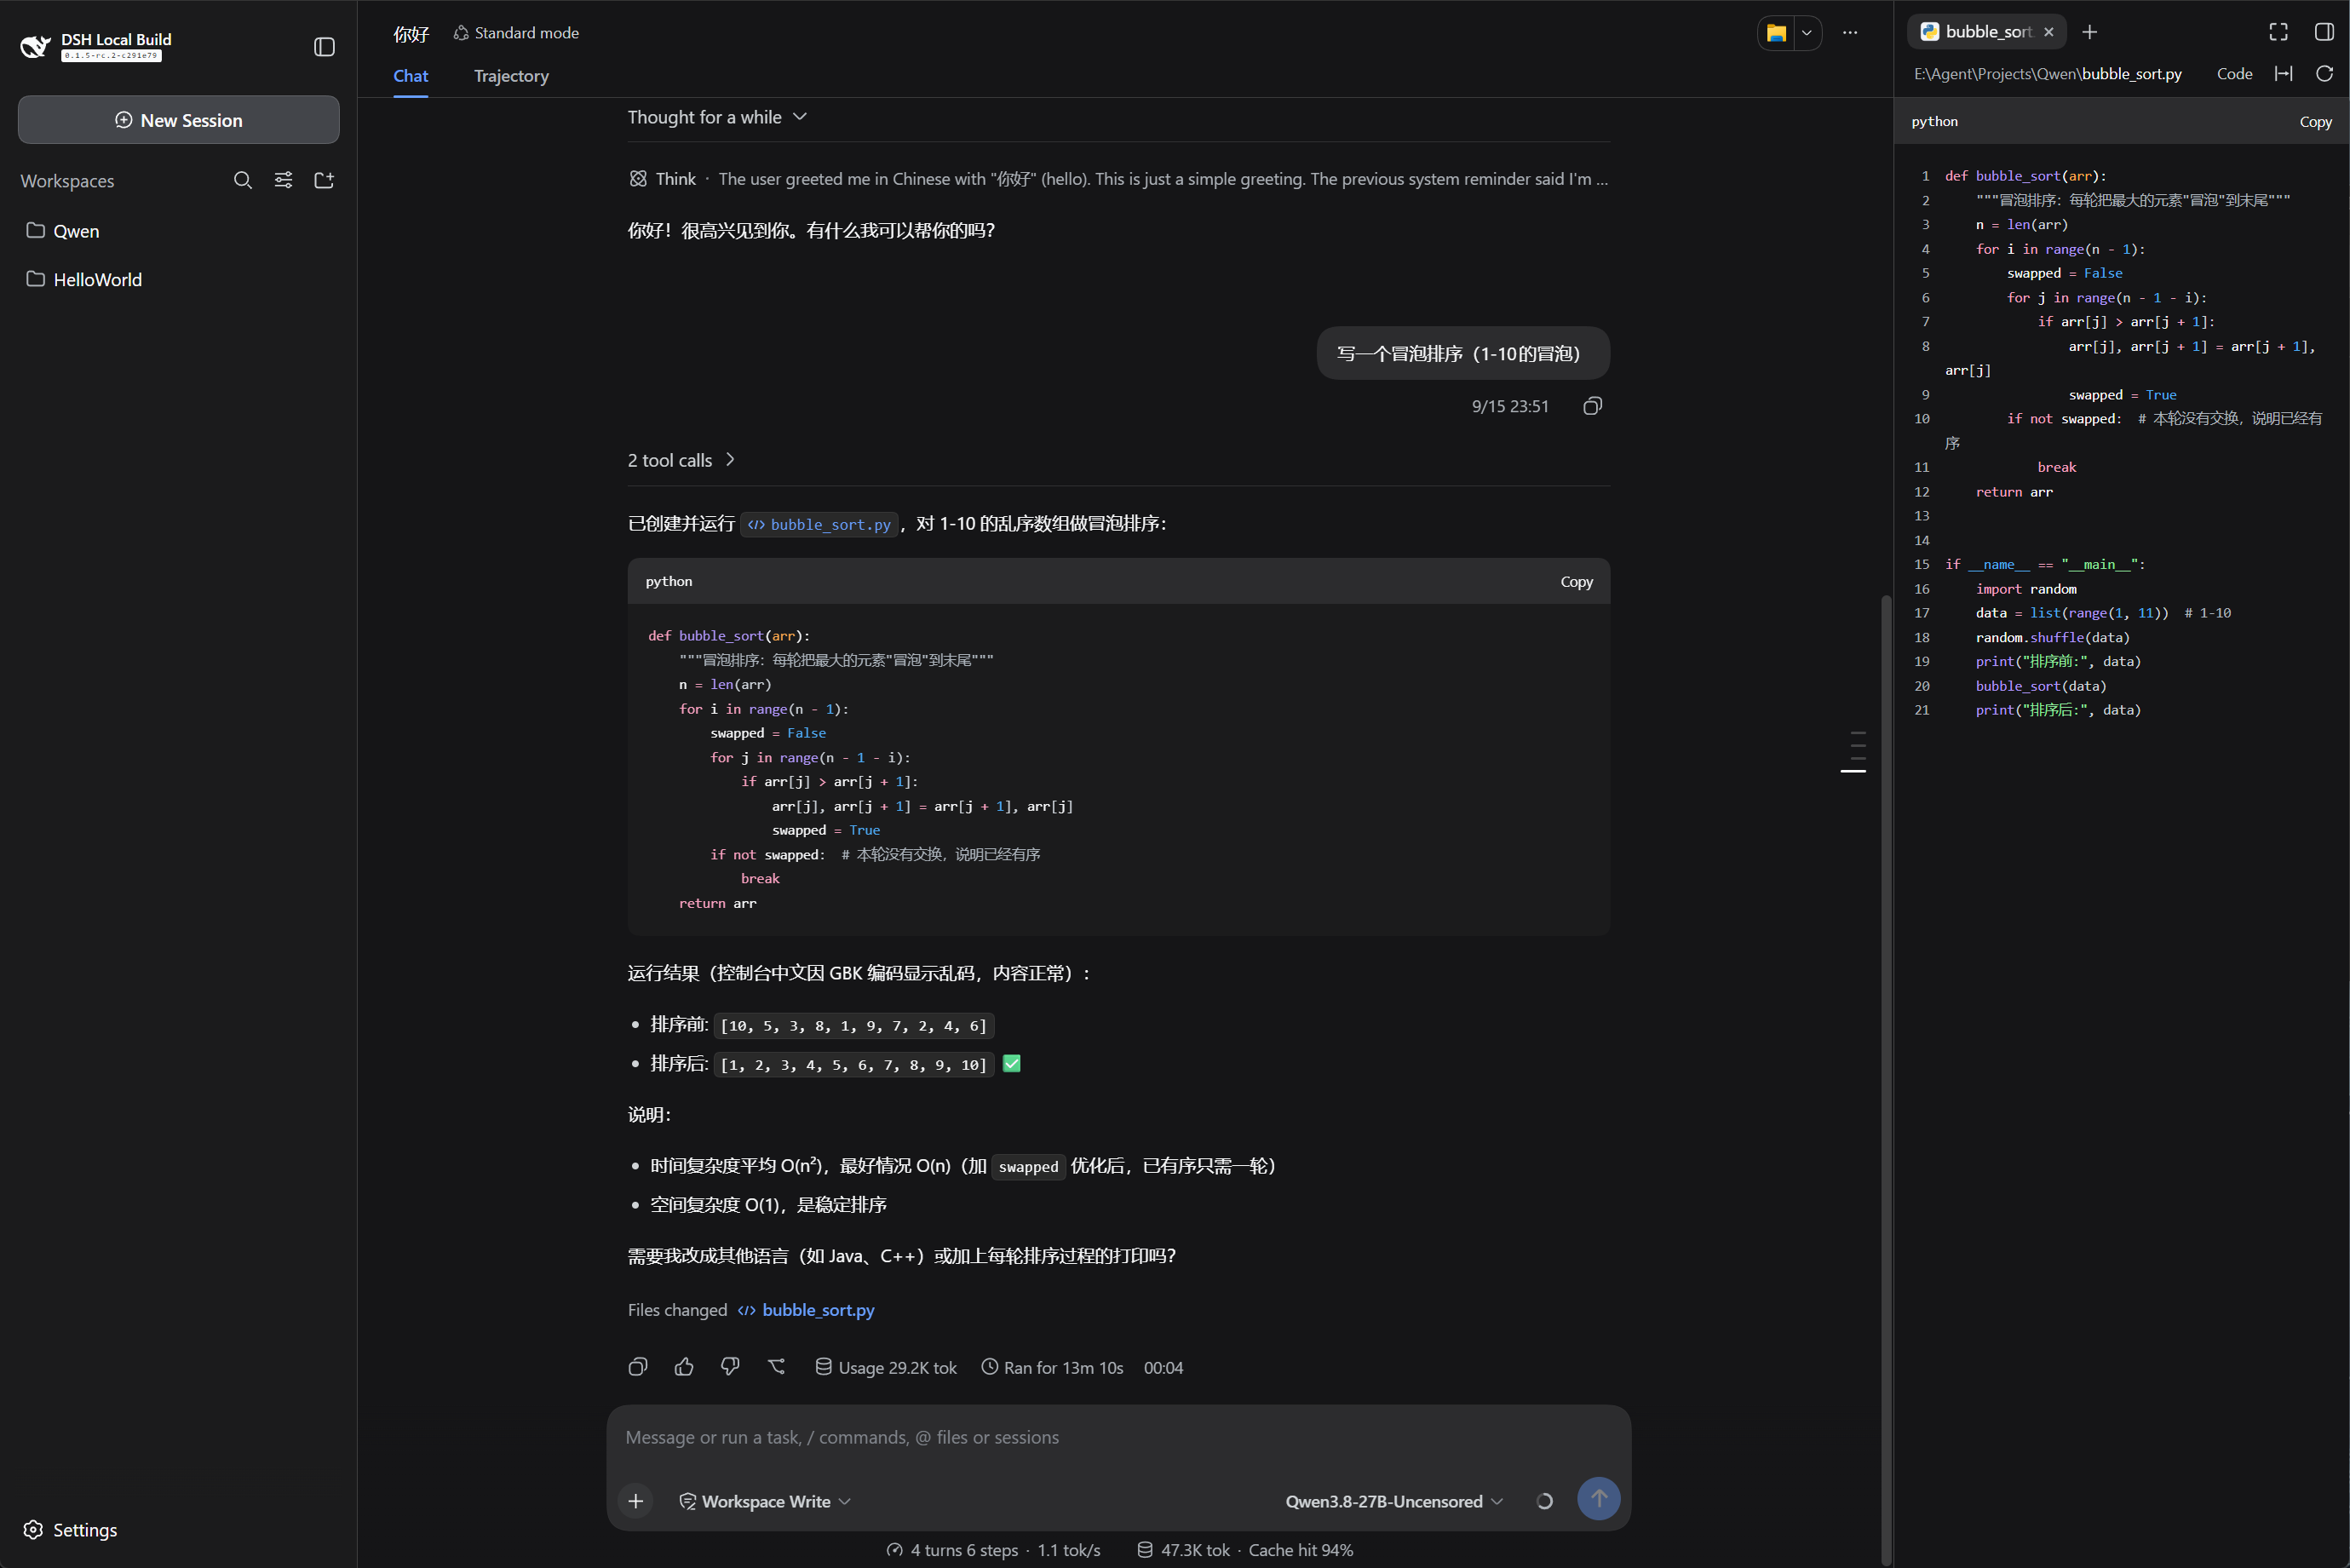
换成 IQ4_XS 后,同类任务耗时约 53 秒:
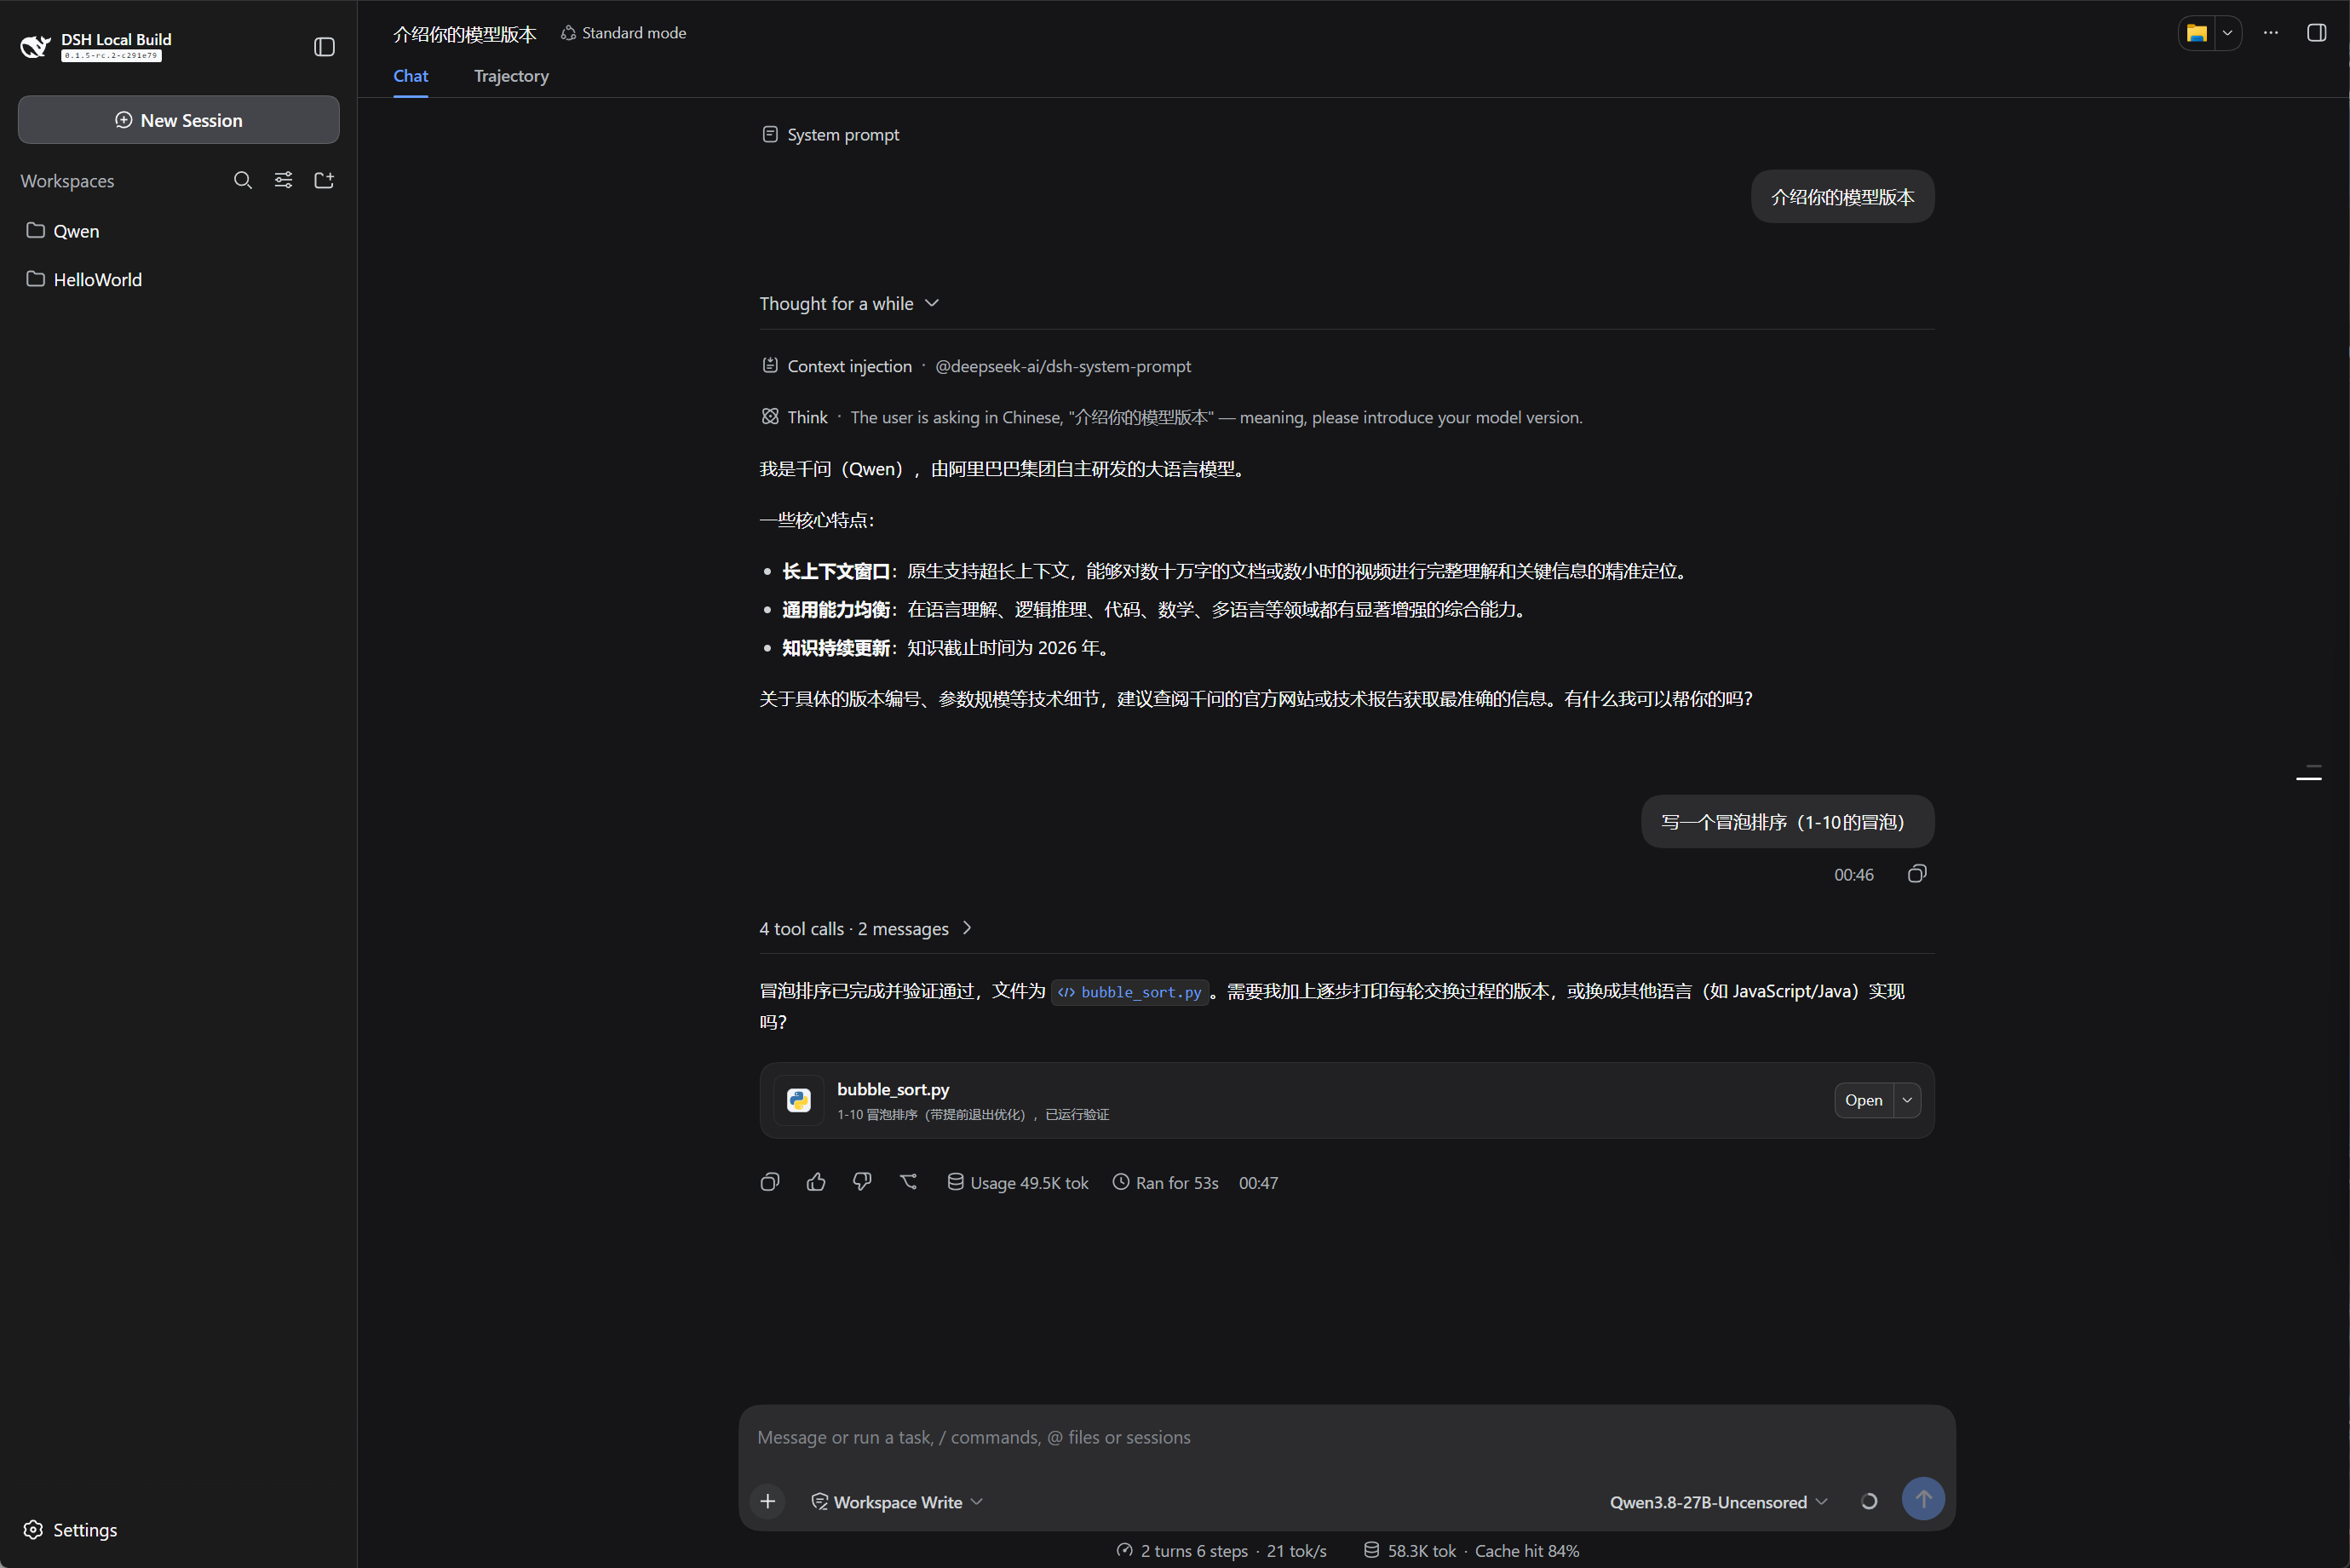
两张截图记录的是实际使用过程,测试条件基本一致,结果仍然很明显:Q4_K_M 的 CPU 层卸载拖慢了整个 Agent 流程,IQ4_XS 把主要权重留在 GPU 后,交互才变得勉强可用。
这次部署留下的几个经验
GPU 利用率高,不等于模型全在 GPU
GPU Load 只能说明 GPU 正在工作。判断速度瓶颈时,还要结合层卸载日志、CPU 线程数、prompt eval 和 eval timing 一起看。图 2 的显存和负载数据只能证明 CUDA 参与了推理,不能证明权重全部在显存里。
--fit on 适合用来减少手工试错
显存会被模型权重、mmproj、KV cache、上下文长度和并发槽共同占用。固定 -ngl 在换模型或换量化档位后很容易失去参考价值。--fit on 不能让超出显存的模型凭空变快,但能按当前条件安排可用层数,并保留溢出时的兜底路径。
DSH 配置的验证要分层
模型出现在列表里,只表示配置被读取;/health 和 /v1/models 正常,只表示服务端可访问;真正使用时还要验证对话、reasoning content 和工具调用。部署记录中曾出现 unauthorized 探测日志,但实际对话请求能够正常返回,因此最终以真实对话链路作为判断依据。
显存带来的差别
这次的差距只来自一个量化档位的更换,却从约 13 分钟变成了 53 秒。Q4_K_M 比 IQ4_XS 大约 2GB,放在显存宽裕的机器上可能只是文件大小的差别;放在 16GB 的 RTX 5080 上,这几 GB 决定了有没有一部分层要交给 CPU。本地模型的体验因此很依赖显存。系统内存可以兜底,能让模型继续加载,但它解决的是“能不能运行”,不一定解决“能不能顺畅交互”。这也是 Mac mini 和 Mac Studio 的统一内存容易让人关注的地方。但统一内存不等于每个模型都更快,也不能直接替代 NVIDIA 显卡的 CUDA 生态;它的优势在于可用内存空间更容易和模型共享。